
مدلهای بزرگ بینایی-زبان-عمل (VLA) چگونه به رباتها قدرت درک و تعامل با جهان فیزیکی میدهند؟
مدلهای VLA با تبدیل حرکات فیزیکی به توکنهای زبانی، شکاف بین استدلال دیجیتال و کنترل رباتیک را از بین میبرند. این معماریها به ماشینها اجازه میدهند تا دانش اینترنتی را مستقیماً به دستورات حرکتی در دنیای واقعی ترجمه کنند.
به قلم فرشید جمشیدی
این خبر را به اشتراک بگذارید
بهطور خلاصه
- مدلهای VLA با تبدیل حرکات فیزیکی به توکنهای زبانی، استدلال مدلهای بزرگ زبانی را به دنیای فیزیکی میآورند.
- تکنیکهای تنظیم دقیق مانند LoRA به این مدلها اجازه میدهند تا بر شکاف تجسم غلبه کرده و رباتهای جدید را کنترل کنند.
- فشردهسازی ساختاری و حذف لایههای اضافی، اجرای مدلهای VLA را روی سختافزارهای ارزانتر و در زمان واقعی ممکن ساخته است.
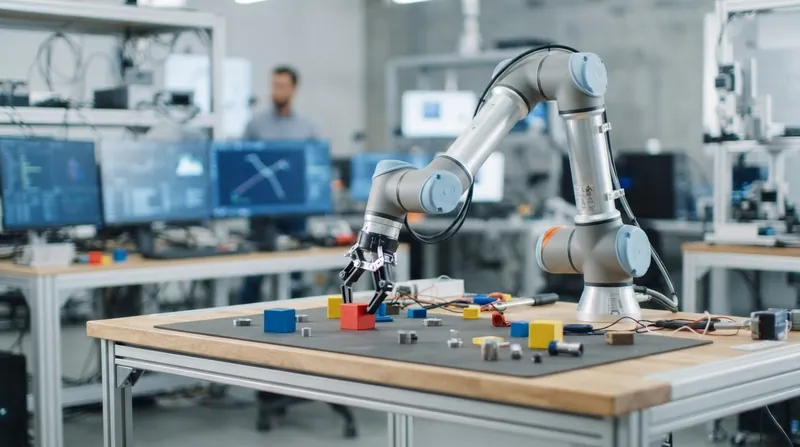
تصور کنید یک مغز مصنوعی با ۷ میلیارد پارامتر، که روی نزدیک به یک میلیون عمل رباتیک در دنیای واقعی آموزش دیده است، میتواند به یک میز شلوغ نگاه کند، دستور «فنجان آبی را بردار» را بشنود و مستقیماً ولتاژ موتورها را برای انجام آن کار تولید کند.
این دقیقاً مقیاس و توانایی مدلهای بزرگ بینایی-زبان-عمل (VLA) است. این سیستمهای پیشرفته نمایانگر یک تغییر بنیادین در نحوه درک و تعامل ماشینها با جهان فیزیکی پیرامون خود هستند و مرزهای هوش مصنوعی تجسمیافته را جابهجا میکنند.
برای دههها، علم رباتیک به خطوط لوله پردازشی چندتکه و مجزا متکی بود. در این سیستمهای سنتی، یک ماژول اشیاء را شناسایی میکرد، سیستم دیگری مسیر حرکت را برنامهریزی میکرد و در نهایت یک کنترلکننده مجزا موتورها را به حرکت درمیآورد.
مدلهای VLA تمام این خط لوله پیچیده را در یک شبکه عصبی واحد فشرده میکنند. آنها شکاف تاریخی بین استدلال دیجیتالی در فضای مجازی و اجرای فیزیکی در دنیای واقعی را به طور کامل از بین میبرند.
با در نظر گرفتن اعمال فیزیکی به عنوان شکل دیگری از زبان، این مدلها به رباتها اجازه میدهند تا از دانش عظیم موجود در اینترنت برای حل مسائل پیشبینینشده در دنیای واقعی استفاده کنند.
ترجمه فیزیک به زبان
مکانیسم اصلی یک مدل VLA بر پایه یک ایده خلاف شهود اما بسیار قدرتمند بنا شده است: در نظر گرفتن حرکات فیزیکی پیوسته به عنوان رشتهای از متن. این رویکرد نحوه پردازش اطلاعات را دگرگون میکند.
در یک مدل زبانی بزرگ (LLM) سنتی، شبکه عصبی کلمه بعدی را در یک دنباله متنی پیشبینی میکند. مدلهای VLA این مفهوم را گسترش میدهند تا به جای کلمات، عمل فیزیکی بعدی ربات را پیشبینی کنند.
این فرآیند پیچیده با عنوان «توکنیزه کردن عمل» شناخته میشود. متغیرهای فیزیکی پیوسته، مانند زاویه دقیق یک بازوی رباتیک یا میزان نیروی گرفتن یک دست مکانیکی، به توکنهای گسسته و قابل فهم برای ماشین تبدیل میشوند.
پژوهشگران گوگل دیپمایند در مقاله بنیادین RT-2 توضیح میدهند: «ما بررسی میکنیم که چگونه مدلهای بینایی-زبان آموزشدیده روی دادههای در مقیاس اینترنت، میتوانند مستقیماً در کنترل رباتیک سرتاسری (End-to-End) ادغام شوند.»[1]
زمانی که مدل یک تصویر را از دوربین خود و یک دستور متنی را از کاربر دریافت میکند، آنها را به صورت یکپارچه پردازش میکند. خروجی این پردازش، رشتهای از توکنهای عمل است که سختافزار ربات آنها را دوباره به حرکت فیزیکی ترجمه میکند.
این رویکرد یکپارچه به این معناست که مدل تنها یک سیب را در تصویر تشخیص نمیدهد؛ بلکه به طور ذاتی درک میکند که چگونه باید گیره رباتیک را قرار دهد تا سیب را بدون له کردن آن از روی میز بردارد.
معماری درک و تعامل
ساخت یک مدل VLA نیازمند ادغام دو نوع متمایز از معماریهای هوش مصنوعی است: رمزگذارهای بصری (Visual Encoders) و ستون فقرات زبانی. این ترکیب به ماشین اجازه میدهد تا هم ببیند و هم استدلال کند.
رمزگذار بصری به عنوان چشمان ربات عمل میکند. در مدلهای متنبازی مانند OpenVLA، این بخش معمولاً ترکیبی از ترانسفورمرهای بینایی تخصصی مانند DINOv2 و SigLIP است که برای درک عمیق تصاویر طراحی شدهاند.[2]
این رمزگذارها ویژگیهای فضایی و معنایی عمیقی را از فید ویدیویی دوربین استخراج میکنند. آنها محیط فیزیکی و اشیاء درون آن را به یک فضای ریاضیاتی نگاشت میکنند که برای مدل زبانی قابل درک باشد.
ستون فقرات زبانی، که اغلب مدلی مانند Llama 2 است، به عنوان موتور استدلال سیستم عمل میکند. این بخش ویژگیهای بصری استخراجشده و دستور متنی کاربر را دریافت کرده و تصمیم میگیرد که ربات در مرحله بعد چه کاری باید انجام دهد.
از آنجا که ستون فقرات زبانی میلیاردها صفحه متن اینترنتی را در طول آموزش خود مطالعه کرده است، گنجینهای از استدلالهای مبتنی بر عقل سلیم را به وظایف فیزیکی و مکانیکی ربات اضافه میکند که پیش از این غیرممکن بود.
اگر به ربات دستور داده شود که «میوه را به داخل کاسه منتقل کن»، مدل میداند که سیب یک میوه است، حتی اگر کلمه «سیب» هرگز به طور صریح در دادههای آموزش رباتیک آن ذکر نشده باشد.
غلبه بر شکاف تجسم
با وجود قدرت بینظیر استدلال و درک محیط، مدلهای VLA با یک چالش فیزیکی منحصربهفرد به نام «شکاف تجسم» (Embodiment Gap) روبرو هستند که استقرار آنها را در سناریوهای دنیای واقعی و محیطهای کنترلنشده بسیار پیچیده میکند.
مدلی که روی دادههای حرکتی یک بازوی رباتیک خاص در یک آزمایشگاه آموزش دیده است، نمیتواند به طور یکپارچه و بدون خطا یک ربات کاملاً متفاوت با مفاصل و موتورهای مجزا را کنترل کند.
ساختار فیزیکی، توزیع وزن، طول بازوها و دینامیک موتورهای ربات جدید، عدم تطابقی جدی با انتظارات و الگوهای یادگرفتهشده مدل ایجاد میکند که میتواند منجر به حرکات اشتباه یا خطرناک شود.
برای حل این مشکل بنیادین، پژوهشگران از تکنیک تنظیم دقیق هدفمند (Fine-tuning) استفاده میکنند. آنها مدل از پیش آموزشدیده VLA را در معرض مجموعه داده کوچکی از نمایشهای حرکتی ربات جدید قرار میدهند تا با فیزیک آن آشنا شود.
تکنیکهایی مانند تطبیق رتبه پایین (LoRA) به مهندسان اجازه میدهند تا تنها کسر بسیار کوچکی از پارامترهای مدل را تغییر دهند. این رویکرد باعث میشود فرآیند انطباق با ربات جدید بسیار سریع و از نظر محاسباتی ارزان باشد.
مطالعات اخیر حتی استقرار مدلهای VLA را روی بازوهای رباتیک نرم و پیوسته نشان دادهاند. این آزمایشها ثابت میکنند که تنظیم دقیق میتواند شکاف بین دادههای آموزشی رباتهای صلب و سختافزارهای انعطافپذیر و غیرقابل پیشبینی را پر کند.[5]
تلاش برای کارایی محاسباتی
اندازه عظیم مدلهای VLA که اغلب بین ۷ میلیارد تا ۵۵ میلیارد پارامتر متغیر است، گلوگاههای محاسباتی قابلتوجهی را برای کنترل رباتیک در زمان واقعی ایجاد میکند و نیازمند سختافزارهای پردازشی بسیار قدرتمندی است.
یک ربات برای واکنش ایمن به یک محیط پویا، باید ورودیهای بصری را پردازش کرده و دستورات حرکتی را در کسری از میلیثانیه تولید کند. مدلهای سنگین تأخیرهای خطرناکی را به این چرخه کنترلی وارد میکنند.
پژوهشگران اکنون در حال کشف این واقعیت هستند که این معماریهای عظیم، زمانی که برای کنترل پیوسته فیزیکی استفاده میشوند، دارای افزونگی بازنمایی لایهای (Layer-wise Redundancy) بسیار شدیدی هستند که میتوان آنها را حذف کرد.
یک مقاله پژوهشی در سال ۲۰۲۶ با عنوان «تنظیم دقیق مدلهای بینایی-زبان-عمل به لایههای کمتری از آنچه فکر میکنید نیاز دارد» اشاره میکند: «تا ۵۰ درصد از عمق مدل میتواند به طور دائم و بدون افت عملکرد فشرده شود.»[4]
با حذف لایههای دوقلو و اضافی با استفاده از تکنیک تراز هسته مرکزی (Centered Kernel Alignment)، مهندسان میتوانند زمان آموزش مدل را به نصف کاهش داده و استنتاج در زمان واقعی را تا ۳۰ درصد تسریع کنند.
این فشردهسازی ساختاری کاملاً بدون نیاز به آموزش مجدد انجام میشود. این روش نیاز به انتخابگرهای لایه پویا و پیچیده را دور میزند و اجرای مدلهای VLA را روی سختافزارهای تجاری و ارزانقیمت امکانپذیر میسازد.
آینده رباتهای همهمنظوره
تکامل از پیشگامان متنبسته مانند RT-2 به چارچوبهای کارآمد و متنباز مانند OpenVLA، نشاندهنده دموکراتیزه شدن هوش مصنوعی تجسمیافته است. این تغییر پارادایم، دسترسی به فناوریهای پیشرفته رباتیک را برای آزمایشگاههای کوچکتر فراهم میکند.
پژوهشگران دیگر نیازی به مراکز داده عظیم ندارند تا به یک ربات آموزش دهند که چگونه محیط خود را درک کند. دانش بنیادین و درک فیزیکی از قبل در وزنهای از پیش آموزشدیده این مدلها گنجانده شده است.
با رشد مداوم مجموعه دادههای مرجع مانند Open X-Embodiment، تنوع تعاملات فیزیکی و اشیایی که این مدلها درک میکنند، به صورت نمایی گسترش خواهد یافت و قابلیتهای رباتها را به سطح جدیدی ارتقا میدهد.
هدف نهایی در این مسیر، دستیابی به یک سیاست رباتیک همهمنظوره است: یک مدل واحد و یکپارچه که بتوان آن را دانلود کرد، با کمی تنظیم دقیق تطبیق داد و روی هر ماشینی در هر مکانی مستقر کرد.
مدلهای VLA با تلفیق عمق شناختی مدلهای زبانی بزرگ و مهارت فیزیکی سیستمهای رباتیک، در حال تبدیل کردن جهان فیزیکی به یک فضای کاملاً برنامهریزیپذیر و قابل درک برای ماشینها هستند.
اصطلاحات کلیدی
- مدل بینایی-زبان-عمل (VLA)
- یک سیستم هوش مصنوعی که تصاویر و متن را دریافت کرده و مستقیماً دستورات حرکتی برای کنترل ربات تولید میکند.
- توکنیزه کردن عمل (Action Tokenization)
- فرآیند تبدیل حرکات فیزیکی پیوسته (مانند زاویه مفصل) به کلمات یا اعداد گسسته که مدل زبانی بتواند آنها را پردازش کند.
- شکاف تجسم (Embodiment Gap)
- تفاوت بین ساختار فیزیکی رباتی که مدل روی آن آموزش دیده و ربات جدیدی که مدل باید آن را کنترل کند.
- تطبیق رتبه پایین (LoRA)
- یک تکنیک بهینهسازی که اجازه میدهد مدلهای بزرگ را با تغییر دادن تنها بخش کوچکی از پارامترها، برای وظایف جدید تنظیم کرد.
پرسشهای متداول
آیا مدلهای VLA میتوانند رباتهای کاملاً متفاوت را کنترل کنند؟
بله، اما معمولاً به یک مرحله تنظیم دقیق (Fine-tuning) نیاز دارند تا با ساختار فیزیکی، توزیع وزن و موتورهای ربات جدید سازگار شوند.
تفاوت VLA با مدلهای زبانی مانند ChatGPT چیست؟
مدلهای زبانی تنها متن تولید میکنند، اما مدلهای VLA خروجی خود را به شکل دستورات حرکتی و ولتاژ موتور برای تعامل فیزیکی با جهان ارائه میدهند.
چرا آموزش این مدلها به دادههای اینترنتی نیاز دارد؟
دادههای اینترنتی به مدل کمک میکنند تا مفاهیم عمومی مانند رنگها، شکلها و منطق فیزیکی را درک کند، حتی اگر قبلاً آن شیء خاص را در دادههای رباتیک ندیده باشد.
بررسی عمیق دیدگاهها
پژوهشگران هوش مصنوعی تجسمیافته
تمرکز بر یکپارچهسازی کامل درک و عمل در یک مدل واحد.
این گروه معتقدند که دوران سیستمهای رباتیک چندتکه به پایان رسیده است. آنها استدلال میکنند که با تبدیل دستورات حرکتی به توکنهای زبانی، میتوان از قدرت استدلال مدلهای بزرگ زبانی برای حل مسائل فیزیکی پیچیده استفاده کرد. از دیدگاه آنها، مدلهای VLA راه را برای رباتهای همهمنظوره هموار میکنند.
توسعهدهندگان رباتیک متنباز
تلاش برای کاهش هزینههای محاسباتی و دموکراتیزه کردن دسترسی به مدلهای VLA.
این کمپ بر این باور است که مدلهای غولپیکر و بسته مانند RT-2 برای استفاده عملی در آزمایشگاههای کوچک و استارتاپها مناسب نیستند. آنها با توسعه مدلهایی مانند OpenVLA و استفاده از تکنیکهای فشردهسازی، نشان میدهند که میتوان با پارامترهای کمتر و سختافزار ارزانتر، به عملکردی مشابه یا حتی بهتر دست یافت.
مهندسان کنترل کلاسیک
تاکید بر ایمنی، دقت و قابلیت پیشبینی در سیستمهای فیزیکی.
این گروه با احتیاط به مدلهای VLA نگاه میکنند. آنها استدلال میکنند که شبکههای عصبی جعبهسیاه هستند و نمیتوانند تضمینهای ایمنی سختگیرانهای برای محیطهای صنعتی یا تعامل با انسان ارائه دهند. از دیدگاه آنها، VLA باید به عنوان یک لایه برنامهریزی سطح بالا استفاده شود، در حالی که کنترل دقیق موتورها باید در دست الگوریتمهای کلاسیک باقی بماند.
- پژوهشگران هوش مصنوعی تجسمیافته
- تمرکز بر یکپارچهسازی کامل درک و عمل در یک مدل واحد.
- توسعهدهندگان رباتیک متنباز
- تلاش برای کاهش هزینههای محاسباتی و دموکراتیزه کردن دسترسی به مدلهای VLA.
- مهندسان کنترل کلاسیک
- تاکید بر ایمنی، دقت و قابلیت پیشبینی در سیستمهای فیزیکی.
دیدگاههایی که این گزارش پوشش نداده
- قانونگذاران ایمنی صنعتی
- کارگران خطوط تولید
منابع
پوشش منابع
6 منبع
3 دیدگاه شناساییشده

- [1]arXivتوسعهدهندگان رباتیک متنباز
RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
مطالعه در arXiv → - [2]arXivتوسعهدهندگان رباتیک متنباز
OpenVLA: An Open-Source Vision-Language-Action Model
مطالعه در arXiv → - [3]arXivتوسعهدهندگان رباتیک متنباز
An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges
مطالعه در arXiv → - [4]arXivتوسعهدهندگان رباتیک متنباز
Finetuning Vision-Language-Action Models Requires Fewer Layers Than You Think
مطالعه در arXiv → - [5]arXivتوسعهدهندگان رباتیک متنباز
Bridging Embodiment Gaps: Deploying Vision-Language-Action Models on Soft Robots
مطالعه در arXiv → - [6]تیم سردبیری کوهستانپژوهشگران هوش مصنوعی تجسمیافته
تحلیل تیم سردبیری کوهستان
مطالعه در تیم سردبیری کوهستان →
بیشتر در هوش مصنوعی
مشاهده همه →قانونگذاری هوش مصنوعی
آغاز نخستین تحقیقات دفتر هوش مصنوعی اتحادیه اروپا درباره فرار عاملهای خودمختار از آزمایشگاههای اوپنایآی و آنتروپیک
5 منبع
یادگیری ربات
حذف نویز رفتاری چگونه مانع میانگینگیری کورکورانه در یادگیری رباتها میشود؟
7 منبع
اتوماسیون کارخانهای
سرمایهگذاری سالانه یک تریلیون ینی تویوتا برای استقرار ۴۰۰ هزار ربات کارخانهای بدون حذف نیروی انسانی
6 منبع
مکانیک الگوریتم
چگونه جستجوی درخت مونت کارلو با استفاده از فرمول UCB1 بین اکتشاف و بهرهبرداری تعادل ایجاد میکند
3 منبع
نظرات
هر زاویه. هر روز.
اخبار هوش مصنوعی با پوشش کامل منابع و تحلیل دیدگاهها، هر روز و رایگان.