
تحلیل داده
پژوهش کوهستان
بسته شواهد: دقت پایش فاضلاب در پیشبینی شیوع منطقهای ویروسها
4 منبع · 32 روز پیش
توضیح کوهستان
چگونه فرض SUTVA از نابودی استنتاج علی توسط تداخل شبکهای در چارچوب پیامدهای بالقوه جلوگیری میکند
4 منبع · 33 روز پیش
توضیح کوهستان
مکانیسم انتخاب مدل: چرا BIC حقیقت را مییابد، اما AIC پیشبینی را بهینه میکند
7 منبع · 33 روز پیش
بیشتر در تحلیل داده
توضیح کوهستاناستنتاج آماری
چرا ناهمسانی واریانس خطاهای استاندارد را مخدوش میکند و چگونه خطاهای استاندارد استوار ماتریس واریانس را اصلاح میکنند
اقتصادسنجیدانان کلاسیک 40%تشخیصدهندگان آماری 35%نظریهپردازان نمونه کوچک 25%
توضیح کوهستاناستنتاج آماری
چگونه «برآورد بیشینهنمایی» پارامترهایی را مییابد که تابع درستنمایی را به حداکثر میرسانند؟
آماردانان نظری 40%دانشمندان داده کاربردی 40%تحلیلگران کمی 20%
توضیح کوهستانتحلیل رگرسیون
تبدیل ضرایب رگرسیون لگاریتمی-لگاریتمی به کشش قیمتی و رشد درصدی
اقتصادسنجها 40%دانشمندان داده 35%اپیدمیولوژیستها 25%
توضیح کوهستانآمار فضایی
چگونه شاخص موران خوشهبندی فضایی را کمّی میکند و مفروضات رگرسیون استاندارد را در دادههای جغرافیایی باطل میسازد
اقتصادسنجان فضایی 45%تحلیلگران GIS 40%آمارشناسان کلاسیک 15%
توضیح کوهستاننظریه اطلاعات
چگونه واگرایی کولبک-لایبلر میزان از دست رفتن اطلاعات را هنگام تقریب یک توزیع احتمال با توزیع دیگر اندازهگیری میکند
مدافعان واگرایی پیشرو 40%مدافعان واگرایی معکوس 35%طرفداران معیارهای متقارن 25%
توضیح کوهستانریاضیات نظرسنجی
ریشه دوم مجموع مربعات: چرا مقایسه دو نظرسنجی نیازمند حاشیه خطای بزرگتری است؟
متدولوژیستهای آماری 40%روزنامهنگاران داده 35%پژوهشگران شرکتی 25%
توضیح کوهستاندادههای نامتوازن
چرا منحنی Precision-Recall خطاهای دادههای نامتوازن را که ROC AUC پنهان میکند، آشکار میسازد
متخصصان دادههای نامتوازن 50%آمارگران سنتی 30%ذینفعان تجاری 20%
توضیح کوهستاناستنتاج علی
قانون جداسازی-d: گرافهای جهتدار غیرمدور چگونه تمام منابع سوگیری علی را شناسایی و مسدود میکنند
اپیدمیولوژیستهای بالینی 35%نظریهپردازان یادگیری ماشین 35%آمارشناسان کاربردی 30%
توضیح کوهستانمدلسازی آماری
چگونه عامل تورم واریانس، همخطی چندگانه را آشکار کرده و از تورم خطاهای استاندارد در رگرسیون جلوگیری میکند
پژوهشگران کاربردی 40%روششناسان 35%تحلیلگران متغیر پنهان 25%
توضیح کوهستانتحلیل سریهای زمانی
چگونه آزمون ریشه واحد از همبستگی کاذب در سریهای زمانی ناایستا جلوگیری میکند
اقتصادسنجهای کلاسیک 60%پیشبینیکنندگان سریهای زمانی 40%
توضیح کوهستانهندسه نمودار
هندسه فریب: چرا نمودارهای میلهای به مبدأ صفر نیاز دارند اما نمودارهای خطی نه
مصورسازان عملگرا 50%حامیان صفر مطلق 30%ارتباطدهندگان علمی 20%
توضیح کوهستانمعیارهای ارزیابی
چگونه جریمه درجه دوم در ارزیابی پیشبینی RMSE، دادههای پرت را در مقایسه با زیان خطی MAE مجازات میکند
طرفداران آمار استوار 50%پیشبینیکنندگان ریسکگریز 50%
بررسی عمیق کوهستانالگوریتمهای جستجو
چرا الگوریتمهای واژگانی مثل BM25 در جستوجوهای حجیم از بازیابی متراکم عصبی پیشی میگیرند
مهندسان سیستمهای ترکیبی 40%سنتگرایان واژگانی 30%طرفداران بازیابی عصبی 30%
توضیح کوهستانروششناسی نظرسنجی
سازوکار افت قدرت آماری در نظرسنجیهای پیچیده: درون جریمه «اثر طراحی»
روششناسان نظرسنجی 40%پژوهشگران میدانی 40%مصرفکنندگان داده 20%
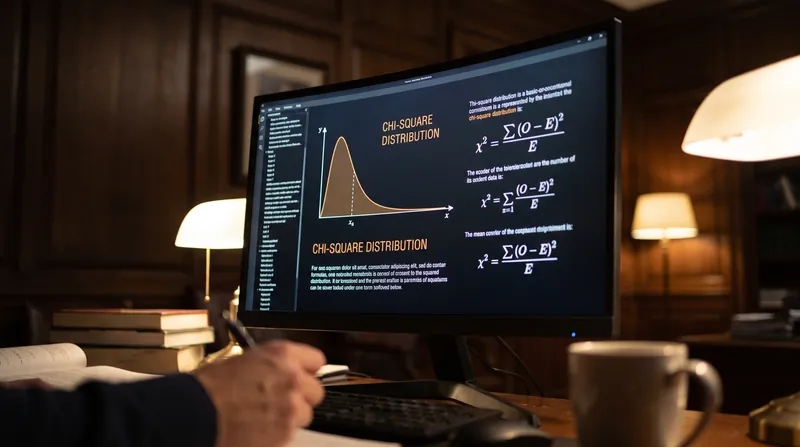
توضیح کوهستاندادههای تابلویی
آزمون هاسمن چگونه دوراهی اثرات ثابت در برابر تصادفی را در دادههای تابلویی حل میکند؟
اولویتدهندگان به عدم سوگیری 40%حداکثرکنندگان کارایی 40%مدافعان تشخیص استوار 20%
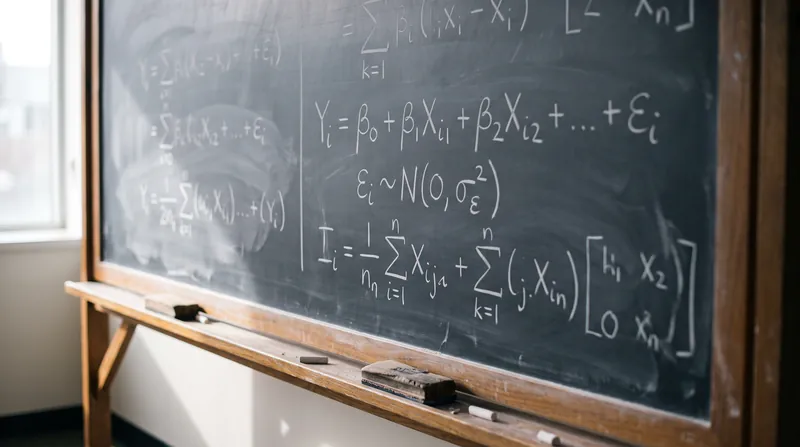
توضیح کوهستانسوگیری متغیر حذفشده
فرمول ریاضی که جهت و بزرگی سوگیری متغیر حذفشده در رگرسیون را تعیین میکند
اقتصادسنجیدانان 40%دانشمندان دادههای پیشبینیکننده 30%مدلسازان ریسک مالی 30%
توضیح کوهستاننظریه آماری
سه شرطی که سازوکار دادههای گمشده را تعریف میکنند (MCAR، MAR، MNAR)
آمارشناسان زیستی بالینی 40%متخصصان یادگیری ماشین 35%نظریهپردازان آماری 25%
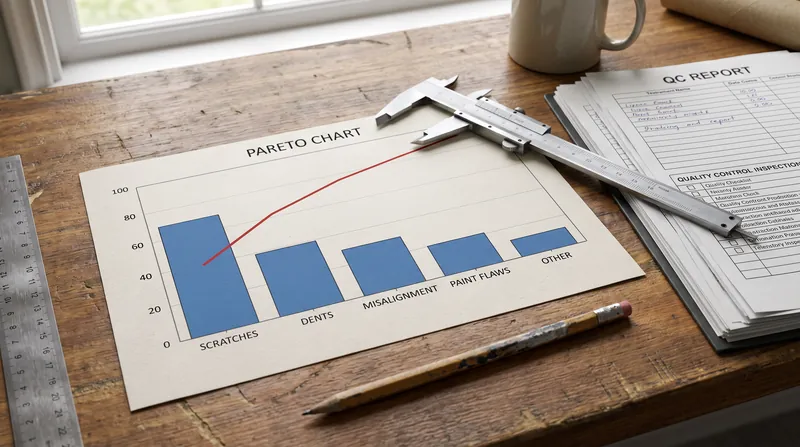
توضیح کوهستانتحلیل نقص
چگونه خط تجمعی در نمودار پارتو اصل ۸۰/۲۰ را در کنترل کیفیت کمیتسنجی میکند
مهندسان کیفیت 40%خالصگرایان آماری 30%متخصصان مدیریت لین 30%
توضیح کوهستانمکانیسم الگوریتم
چرخه پیشبینی-بهروزرسانی فیلتر کالمن چگونه خطای تخمین وضعیت را در سریهای زمانی به حداقل میرساند
مهندسان سیستمهای کنترل 40%دانشمندان داده 30%توسعهدهندگان رباتیک 30%
توضیح کوهستانعلم شبکه
چگونه الگوریتمهای بینابینی، نزدیکی و بردار ویژه، قدرت را در یک شبکه تعریف میکنند
تحلیلگران توپولوژی 35%نظریهپردازان اطلاعات 35%مهندسان محاسبات 30%
توضیح کوهستاناستنتاج علی
چگونه تصادفیسازی محلی در نزدیکی یک نقطه برش، اثرات علی را در دادههای مشاهدهای مجزا میکند
تجربهگرایان مبتنی بر طراحی 45%روششناسان الگوریتمی 30%اقتصادسنجیدانان کاربردی 25%
توضیح کوهستاناستنتاج علی
چگونه الگوریتمهای کنترل ساختگی با ایجاد سناریوهای جایگزین، نتایج سیاستگذاریها را میسنجند
متدولوژیستهای استنتاج علی 45%اقتصاددانان کاربردی 40%شکاکان آماری 15%
مدلسازی آماریتشریح روششناسی
چگونه یک متغیر میانجی مسیر علی را توضیح میدهد، در حالی که یک متغیر تعدیلگر شدت آن را تغییر میدهد
چارچوب رگرسیون سنتی 44%تحلیل فرایند محاسباتی 33%استنتاج علی ساختاری 22%
توضیح کوهستانتوان آماری
چگونه اندازه اثر، آلفا و توان آماری برای تعیین حجم نمونه آزمایش در هم قفل میشوند
متدولوژیستهای بالینی 40%دانشمندان داده فراوانیگرا 40%منتقدان بیزی 20%
توضیح کوهستانمصورسازی دادهها
چگونه نمودارهای دو محوره همبستگیهای کاذب میسازند و چرا نمودارهای نسبتی این اعوجاج را برطرف میکنند
خالصگرایان مصورسازی داده 50%تحلیلگران عملگرا 35%مدافعان زمینهگرا 15%
توضیح کوهستاناستنتاج علی
چگونه سه شرط ریاضی اعتبار یک متغیر ابزاری را تایید میکنند
نابگرایان اقتصادسنجی 40%ارزیابان کاربردی سیاستها 30%روششناسان اپیدمیولوژیک 30%
توضیح کوهستانتنظیمات چندگانگی
چگونه تنظیمات بونفرونی و نرخ کشف کاذب از مثبتهای کاذب در مجموعهدادههای عظیم جلوگیری میکنند
کنترلکنندگان سختگیر خطا 40%محققان اکتشافی 40%اصلاحطلبان روششناسی 20%
توضیح کوهستانقابلیت اطمینان بین ارزیابان
چرا توافق درصد ساده در دادههای نامتوازن شکست میخورد و چگونه کاپای کوهن آن را اصلاح میکند
ارزیابان یادگیری ماشین 40%تشخیصدهندگان بالینی 40%روششناسان آماری 20%
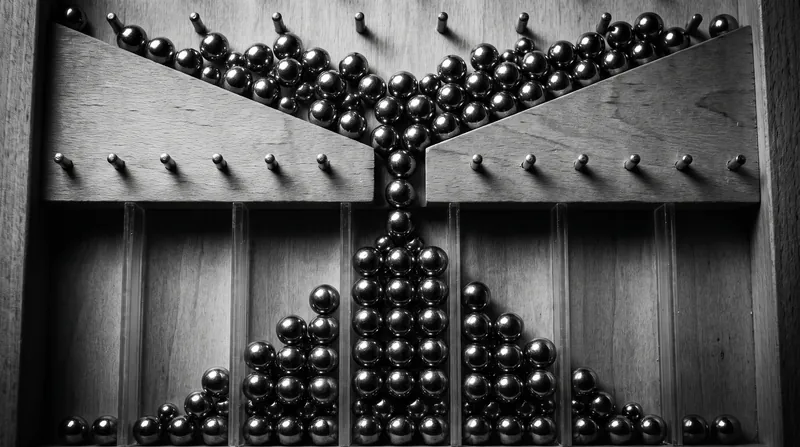
توضیح کوهستاننظریه آماری
چگونه قضیه حد مرکزی آشوب را مجبور به تبعیت از منحنی زنگولهای میکند
آمارشناسان کاربردی 45%روششناسان نظرسنجی 30%ریاضیدانان نظری 25%
توضیح کوهستاننظریه آمار
چگونه نابرابری کرامر-رائو کف مطلق واریانس آماری را تعیین میکند
آمارشناسان نظری 40%دانشمندان داده کاربردی 35%مهندسان پردازش سیگنال 25%
توضیح کوهستانروشهای بازنمونهگیری
چگونه بازنمونهگیری با جایگذاری، توزیع نمونهگیری هر آمارهای را تخمین میزند؟
آمارشناسان محاسباتی 40%دانشمندان داده کاربردی 40%نظریهپردازان پارامتریک کلاسیک 20%
توضیح کوهستانبصریسازی داده
چگونه نمودارهای ویولن، چندوجهیهای پنهانی را که آمار خلاصه حذف میکند، آشکار میسازند
بصریسازان داده 40%سنتگرایان آماری 30%عملگرایان الگوریتمی 30%
توضیح کوهستانسری زمانی
کالبدشکافی آریما: چگونه خودرگرسیون، تفاضلگیری و میانگین متحرک برای پیشبینی سریهای زمانی ترکیب میشوند
آمارشناسان کلاسیک 40%پیشبینیکنندگان تجاری 35%متخصصان یادگیری ماشینی 25%
توضیح کوهستانپیشپردازش داده
چگونه یک داده پرت جدول ردهبندی را زیر و رو میکند: شکاف ریاضی بین استانداردسازی نمره Z و نرمالسازی مین-مکس
حافظان واریانس 60%حامیان مرزهای سختگیرانه 40%
توضیح کوهستانمعیارهای طبقهبندی
چرا معیار F1 (اف-وان) عدم توازن شدید بین دقت (Precision) و فراخوانی (Recall) را در یادگیری ماشین جریمه میکند؟
طرفداران معیار متوازن 45%تنظیمکنندگان آستانه 30%شکاکان به قابلیت تفسیر 25%
توضیح کوهستانفناوری پوشیدنی
بررسی شواهد: ساعتهای هوشمند تجاری تا چه حد معماری خواب را در مقایسه با پلیسومنوگرافی بالینی اندازهگیری میکنند؟
محققان بالینی خواب 40%حامیان دستگاههای پوشیدنی مصرفی 35%مهندسان سختافزار 25%
توضیح کوهستانروشهای تنظیمکنندگی
چگونه تنظیمکنندگی L1 ضرایب را به صفر میرساند در حالی که رگرسیون ریج همه آنها را حفظ میکند
حامیان دقت پیشبینی 35%حامیان تفسیرپذیری 35%متخصصان ترکیبی 30%
توضیح کوهستاناستنتاج علّی
چگونه مرزهای عددی دلخواه، علت و معلول را در دادههای مشاهدهای جدا میکنند
اقتصادسنجان 40%پژوهشگران بالینی 35%ارزیابان سیاست 25%
توضیح کوهستاندادههای گمشده
چرا جایگزینی با میانگین، واریانس دادهها را مخدوش میکند و چگونه معادلات زنجیرهای آن را حفظ میکنند؟
محققان کاربردی 40%آمارشناسان محاسباتی 35%متخصصان علم داده 25%
توضیح کوهستانبصریسازی دادهها
نرمالسازی دادهها در نقشههای کوروپلت: چرا استفاده از شمارش خام به جای نرخ، روندهای جغرافیایی را تحریف میکند
استانداردهای نقشهکشی 40%متدولوژی آماری 40%دانش باز و ترکیببندی 20%
پژوهش کوهستانمدلهای آب و هوای هوش مصنوعی
بسته شواهد: دقت و محدودیتهای مدلهای پیشبینی آب و هوای مبتنی بر هوش مصنوعی
آزمایشگاههای تحقیقاتی هوش مصنوعی 45%آژانسهای ملی پیشبینی 35%فیزیکدانان جوی 20%
توضیح کوهستانالگوریتمهای رتبهبندی
سازوکار تجمیع رتبهبندی: چگونه الگوریتمها برنده دادههای رتبهبندیشده را تعیین میکنند
خالصگرایان الگوریتمی 35%سازندگان اجماع 35%عملگرایان 30%
توضیح کوهستانمتدولوژی نظرسنجی
سازوکار خطای کلی نظرسنجی: مقایسه سوگیریهای نمونهگیری، پوشش، اندازهگیری و عدم پاسخگویی
روششناسان نظرسنجی 40%نظرسنجیکنندگان تجاری 35%مصرفکنندگان داده 25%
پژوهش کوهستانروندهای محیط کار
شواهد پشت پرده هفته کاری چهار روزه: بهرهوری، حفظ کارکنان و محدودیتهای دادهها
طرفداران مدل ۱۰۰-۸۰-۱۰۰ 40%محققان کار و رفاه 40%رهبران صنعت شکاک 20%
پژوهش کوهستاننقشهبرداری فقر
بسته شواهد: دقت نقشهبرداری فقر با استفاده از تصاویر ماهوارهای و یادگیری ماشین
اقتصاددانان توسعه 45%محققان جغرافیایی فضایی 35%اخلاقمداران داده 20%
توضیح کوهستاناستنتاج علّی
مکانیسم تطبیق نمره تمایل: چگونه مطالعات مشاهدهای، کارآزماییهای کنترلشده تصادفی را شبیهسازی میکنند
حامیان شواهد دنیای واقعی 45%متعصبان کارآزمایی بالینی 30%شکاکان روششناختی 25%
کاوش موضوعات بیشتر
تعداد در هر صفحه