
تحلیل داده
تحلیل دادههای ترافیک دریایی: چگونه نوسانات عبور کشتیها از تنگه هرمز اندازهگیری میشود
5 منبع · 3 روز پیش
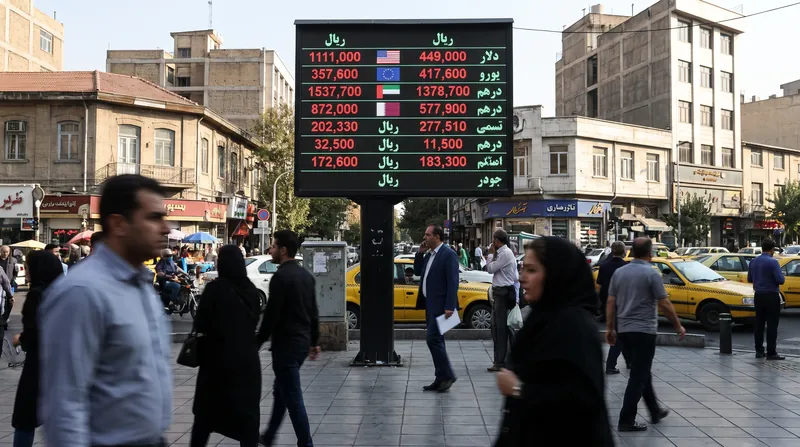
تحلیل دادههای نوسان نرخ ارز: عملکرد ۱۲ ماهه ریال در برابر دلار و یورو
4 منبع · 3 روز پیش
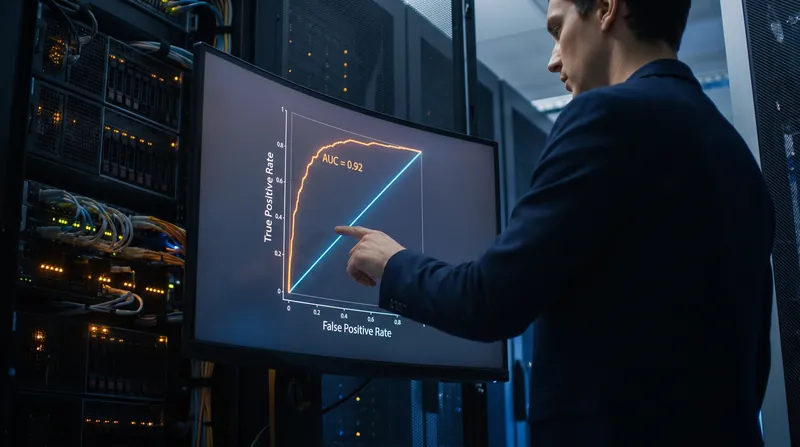
چگونه مساحت زیر منحنی ROC همان احتمال رتبهبندی درست یک نمونه مثبت بالاتر از نمونه منفی است
7 منبع · 4 روز پیش
بیشتر در تحلیل داده
چگونه پهنای مخروط عدم قطعیت با جذر زمان پیشبینی افزایش مییابد
6 منبع · 4 روز پیش
مکانیسم ضریب تعیین تعدیلشده: چگونه جریمه ریاضی متغیرهای بیربط مانع از بیشبرازش مدل میشود
10 منبع · 4 روز پیش
چگونه یک مقدار ویژه نزدیک به صفر در ماتریس طراحی، همخطی چندگانه را در رگرسیون آشکار میکند
6 منبع · 4 روز پیش
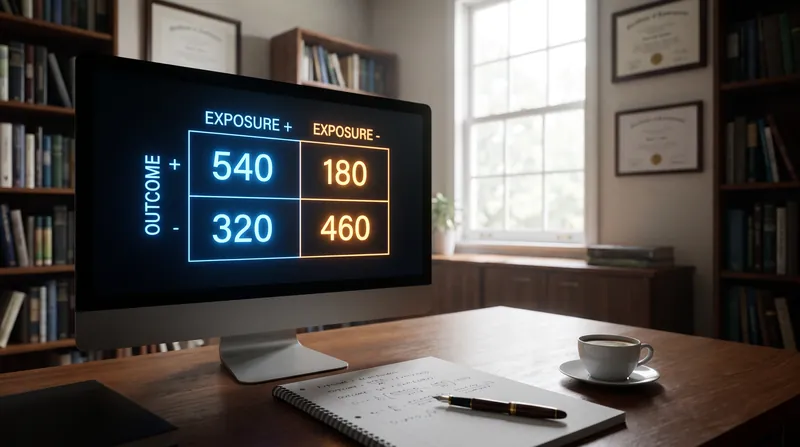
چگونه فراوانی مورد انتظار در یک جدول توافقی، از ضرب مجموعهای حاشیهای تقسیم بر مجموع کل به دست میآید
6 منبع · 4 روز پیش
فرض عدم مخدوششدگی: چرا احتمال تخصیص درمان باید مستقل از پیامدهای بالقوه باشد؟
6 منبع · 5 روز پیش
پنج فرضی که تضمین میکنند حداقل مربعات معمولی بهترین برآوردگر خطی نااریب است
6 منبع · 6 روز پیش
چگونه «ضریب دروغ» انحرافات گرافیکی را به صورت ریاضی اندازهگیری میکند
5 منبع · 6 روز پیش
چگونه آلفای کرونباخ تابعی از تعداد گویهها و میانگین همبستگی بین آنهاست
7 منبع · 6 روز پیش
چگونه آماره F واریانس تبیینشده را با واریانس پسماند تبییننشده مقایسه میکند
6 منبع · 6 روز پیش
چگونه پارامتر پراکندگی در رگرسیون دوجملهای منفی، بیشپراکندگی دادههای شمارشی را مهار میکند
6 منبع · 7 روز پیش
فاکتور بیز: چگونه نسبت درستنماییهای حاشیهای شواهد فرضیههای رقیب را کمیتسنجی میکند
8 منبع · 7 روز پیش
تبدیل ریشه دوم: چرا شعاع در نمودارهای حبابی باید با جذر دادهها متناسب باشد؟
8 منبع · 8 روز پیش
بدهبستان ریاضیاتی میان میانگین و میانه در بهینهسازی تابع زیان
4 منبع · 8 روز پیش
فاصله کوک چگونه تغییر ضرایب رگرسیون را با حذف یک داده منفرد اندازهگیری میکند؟
7 منبع · 8 روز پیش
چگونه گامهای امید ریاضی و بیشینهسازی برای یافتن متغیرهای پنهان به برآورد بیشینه درنمایی همگرا میشوند
4 منبع · 8 روز پیش
چگونه تحلیل «قصد درمان» (ITT) تصادفیسازی را حفظ کرده و از سوگیری انتخاب جلوگیری میکند
9 منبع · 8 روز پیش
چگونه پارامتر میرایی در هموارسازی نمایی بین واکنشپذیری به دادههای جدید و پایداری تعادل ایجاد میکند
6 منبع · 9 روز پیش
چگونه اعتبارسنجی متقاطع K-Fold سوگیری و واریانس را برای تخمین خطای تعمیم مدل متعادل میکند
6 منبع · 9 روز پیش
چگونه نسبت ابعاد در نمودارهای خطی سری زمانی، درک ما از نوسانات و روندها را تعیین میکند
7 منبع · 9 روز پیش
چگونه جریمه L1 در رگرسیون لاسو برای انتخاب ویژگی، ضرایب را به صفر میرساند
6 منبع · 9 روز پیش
چگونه روش بوتاسترپ با استفاده از بازنمونهگیری، توزیع نمونهبرداری هر آمارهای را تخمین میزند
6 منبع · 9 روز پیش
چرا بازه اطمینان ۹۵ درصدی به معنای احتمال ۹۵ درصدی برای یافتن میانگین واقعی در آن محدوده نیست؟
10 منبع · 10 روز پیش
دادههای کشاورزی ارگانیک در برابر سنتی: چرا اثرات زیستمحیطی به نحوه اندازهگیری شما بستگی دارد
5 منبع · 10 روز پیش
نقص هندسی نمودارهای راداری: سازوکار اختلال مساحت بر اثر ترتیب محورها و خطای مقایسههای چندمعیاره
5 منبع · 10 روز پیش
چگونه آزمون علیت گرنجر تقدم پیشبینانه را میسنجد، نه اثرگذاری علی واقعی را
6 منبع · 10 روز پیش
بسته شواهد: بدهبستانهای ریاضیاتی میان آزمونهای والد، اسکور و نسبت درستنمایی
7 منبع · 10 روز پیش
چگونه حداقل اثر قابلتشخیص، توان آماری و آلفا، حجم نمونه مورد نیاز برای تست A/B را تعیین میکنند
6 منبع · 10 روز پیش
بسته شواهد: دقت و سبکسنگین کردن SMOTE در برابر وزندهی کلاسها در دادههای نامتوازن
6 منبع · 10 روز پیش
پرونده شواهد: چگونه در مدلهای تجمعی، «بگینگ» واریانس را کاهش میدهد و «بوستینگ» سوگیری را
7 منبع · 11 روز پیش
پرونده شواهد: دقت و محدودیتهای تطبیق نمره گرایش در تحقیقات مشاهدهای
6 منبع · 11 روز پیش
بسته شواهد: بدهبستانهای دقت و کارایی در حریم خصوصی تفاضلی
5 منبع · 11 روز پیش
چگونه ضخامت خطوط در نمودار سنکی، حجم جریان و اصل بقا را نشان میدهد
7 منبع · 11 روز پیش
پرونده شواهد: دقت دادههای جایگزین با فرکانس بالا در پیشبینی لحظهای اقتصاد کلان
5 منبع · 11 روز پیش
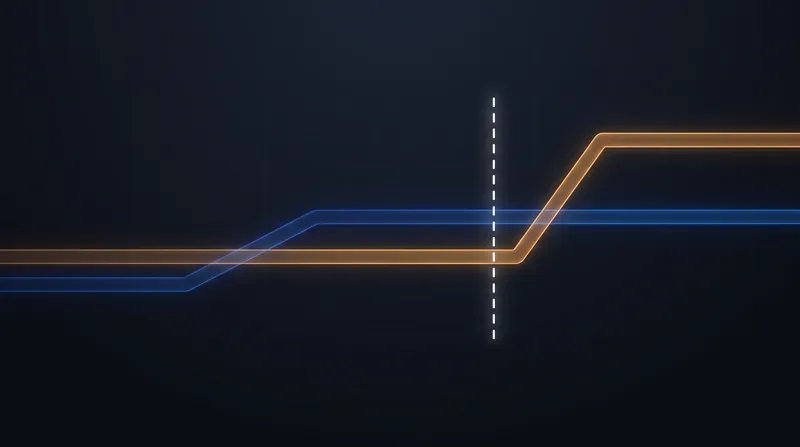
چگونه فرض روندهای موازی، وضعیت خلاف واقع را در تخمین تفاضل در تفاضل اعتبار میبخشد
6 منبع · 11 روز پیش
سیستم امتیازدهی الو چگونه بر اساس تابع لجستیکِ احتمال برد، امتیاز بازیکنان را تنظیم میکند؟
3 منبع · 11 روز پیش
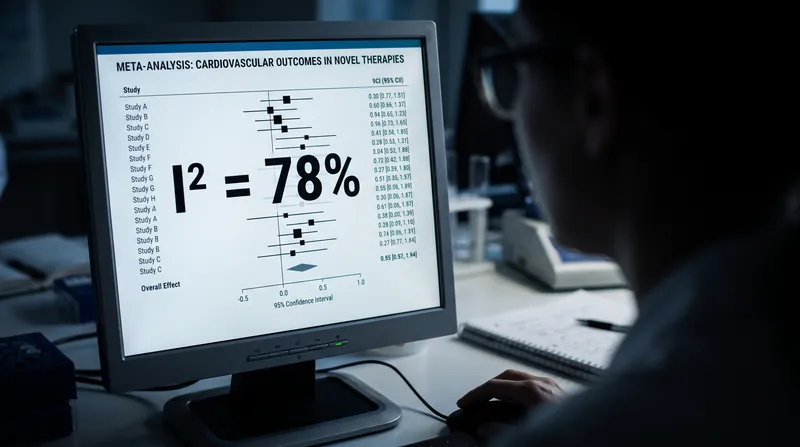
چگونه آماره I² درصد تغییرات ناشی از ناهمگنی را در یک متاآنالیز کمّی میکند
6 منبع · 11 روز پیش
چگونه تابع آلفا-اسپندینگ از نتایج مثبت کاذب در نظارت مستمر بر تستهای A/B جلوگیری میکند
4 منبع · 12 روز پیش
چگونه بردارهای ویژه ماتریس کوواریانس، جهتهای بیشترین واریانس را در تحلیل مؤلفههای اصلی تعیین میکنند
6 منبع · 12 روز پیش
چگونه خطای معیار در مقایسه با انحراف معیار، واریانس ظاهری را فشرده میکند
9 منبع · 12 روز پیش
چرا بازههای پیشبینی هرگز به صفر نمیرسند، اما بازههای اطمینان چرا؟
7 منبع · 12 روز پیش
ضریب اسپیرمن در برابر تاوی کندال: بدهبستانهای ریاضی در همبستگی رتبهای
5 منبع · 13 روز پیش

پرونده شواهد: دقت قانون بنفورد در کشف تقلبهای مالی و انتخاباتی
6 منبع · 13 روز پیش

چگونه الگوریتم متروپولیس-هیستینگز با دور زدن ریاضیات پیچیده، احتمالات درهمتنیده را ترسیم میکند
9 منبع · 13 روز پیش

خطای ۷.۵ درصدی؛ چگونه طیف رنگی رنگینکمانی دادهها را تحریف میکند
6 منبع · 13 روز پیش
سنجش شکاف ثروت: هندسه منحنی لورنز چگونه ضریب جینی را محاسبه میکند
7 منبع · 14 روز پیش
دقت یادگیری عمیق در برابر مدل ETAS در پیشبینی پسلرزهها
6 منبع · 14 روز پیش
کاوش موضوعات بیشتر
نمایش 1 تا 50 از 250