
تحلیل داده
چگونه برازش متناسب تکرارشونده، نمونههای نظرسنجی را با آمارهای جمعیتی همسو میکند
5 منبع · 11 روز پیش
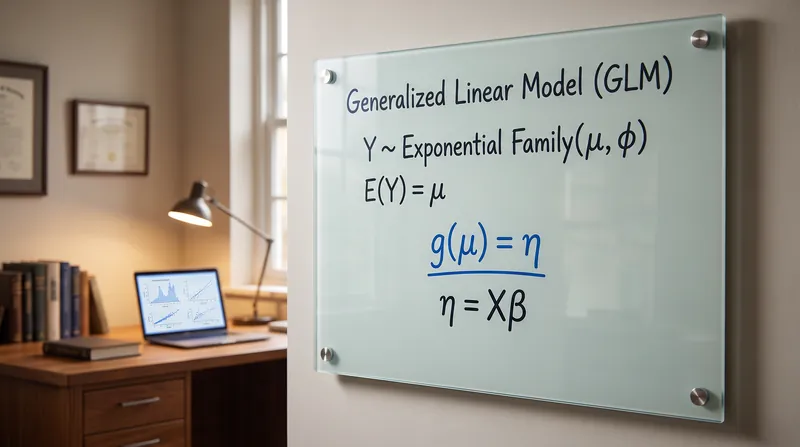
چگونه تابع پیوند، پیشبین خطی را به برآمد مورد انتظار در مدلهای خطی تعمیمیافته متصل میکند
8 منبع · 11 روز پیش
چگونه ۱۰۰ میلیون نقاشی کودکان، دو دهه از روندهای فرهنگی را آشکار میکند
4 منبع · 11 روز پیش
بیشتر در تحلیل داده
چگونه مقادیر SHAP پیشبینی یک مدل جعبهسیاه را به سهم هر ویژگی تجزیه میکنند
7 منبع · 11 روز پیش
چگونه سلسلهمراتب کلیولند-مکگیل رمزگذاریهای بصری را بر اساس دقت رتبهبندی میکند
7 منبع · 11 روز پیش
ریاضیات سوگیری تضعیف: چگونه متغیرهای پیشبینِ نویزدار، شیبهای رگرسیون را مسطح میکنند
6 منبع · 12 روز پیش
چگونه جفت مزدوج بتا-دوجملهای باورهای پیشین را به احتمالات پسین تبدیل میکند
6 منبع · 12 روز پیش
بسته شواهد: دقت پایش فاضلاب در پیشبینی شیوع منطقهای ویروسها
4 منبع · 12 روز پیش
چگونه فرض SUTVA از نابودی استنتاج علی توسط تداخل شبکهای در چارچوب پیامدهای بالقوه جلوگیری میکند
4 منبع · 12 روز پیش
مکانیسم انتخاب مدل: چرا BIC حقیقت را مییابد، اما AIC پیشبینی را بهینه میکند
7 منبع · 12 روز پیش
چرا ناهمسانی واریانس خطاهای استاندارد را مخدوش میکند و چگونه خطاهای استاندارد استوار ماتریس واریانس را اصلاح میکنند
6 منبع · 12 روز پیش
چگونه «برآورد بیشینهنمایی» پارامترهایی را مییابد که تابع درستنمایی را به حداکثر میرسانند؟
7 منبع · 12 روز پیش
تبدیل ضرایب رگرسیون لگاریتمی-لگاریتمی به کشش قیمتی و رشد درصدی
6 منبع · 13 روز پیش
چگونه شاخص موران خوشهبندی فضایی را کمّی میکند و مفروضات رگرسیون استاندارد را در دادههای جغرافیایی باطل میسازد
6 منبع · 13 روز پیش
چگونه واگرایی کولبک-لایبلر میزان از دست رفتن اطلاعات را هنگام تقریب یک توزیع احتمال با توزیع دیگر اندازهگیری میکند
6 منبع · 13 روز پیش
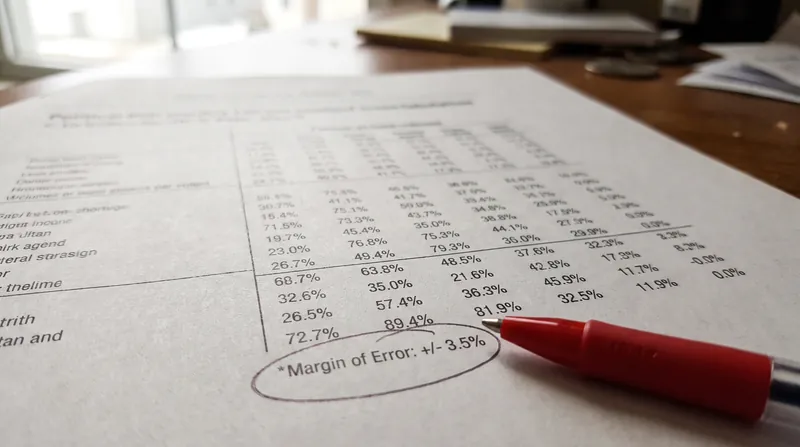
ریشه دوم مجموع مربعات: چرا مقایسه دو نظرسنجی نیازمند حاشیه خطای بزرگتری است؟
7 منبع · 13 روز پیش
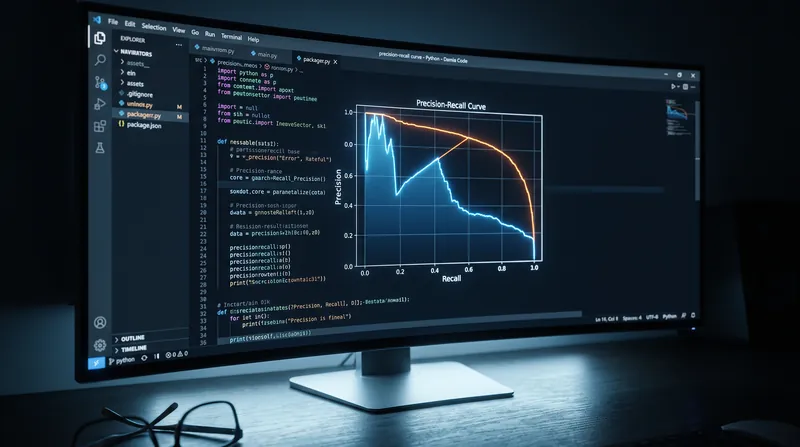
چرا منحنی Precision-Recall خطاهای دادههای نامتوازن را که ROC AUC پنهان میکند، آشکار میسازد
6 منبع · 13 روز پیش
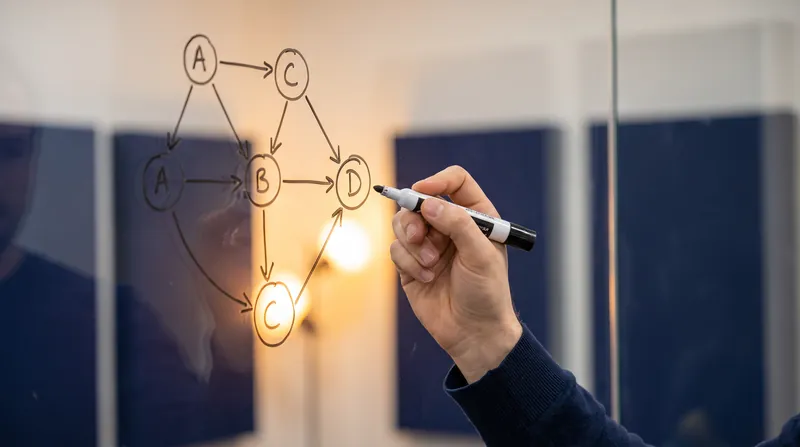
قانون جداسازی-d: گرافهای جهتدار غیرمدور چگونه تمام منابع سوگیری علی را شناسایی و مسدود میکنند
6 منبع · 13 روز پیش
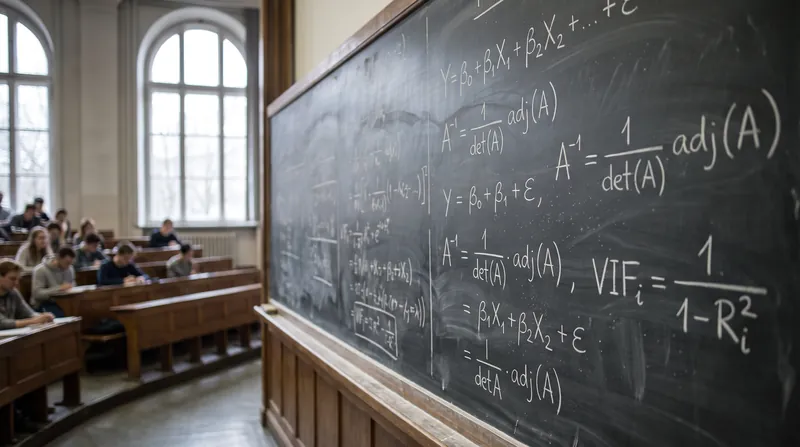
چگونه عامل تورم واریانس، همخطی چندگانه را آشکار کرده و از تورم خطاهای استاندارد در رگرسیون جلوگیری میکند
6 منبع · 13 روز پیش
چگونه آزمون ریشه واحد از همبستگی کاذب در سریهای زمانی ناایستا جلوگیری میکند
7 منبع · 13 روز پیش
هندسه فریب: چرا نمودارهای میلهای به مبدأ صفر نیاز دارند اما نمودارهای خطی نه
7 منبع · 14 روز پیش
چگونه جریمه درجه دوم در ارزیابی پیشبینی RMSE، دادههای پرت را در مقایسه با زیان خطی MAE مجازات میکند
5 منبع · 14 روز پیش
چرا الگوریتمهای واژگانی مثل BM25 در جستوجوهای حجیم از بازیابی متراکم عصبی پیشی میگیرند
2 منبع · 14 روز پیش
سازوکار افت قدرت آماری در نظرسنجیهای پیچیده: درون جریمه «اثر طراحی»
9 منبع · 14 روز پیش
آزمون هاسمن چگونه دوراهی اثرات ثابت در برابر تصادفی را در دادههای تابلویی حل میکند؟
6 منبع · 14 روز پیش
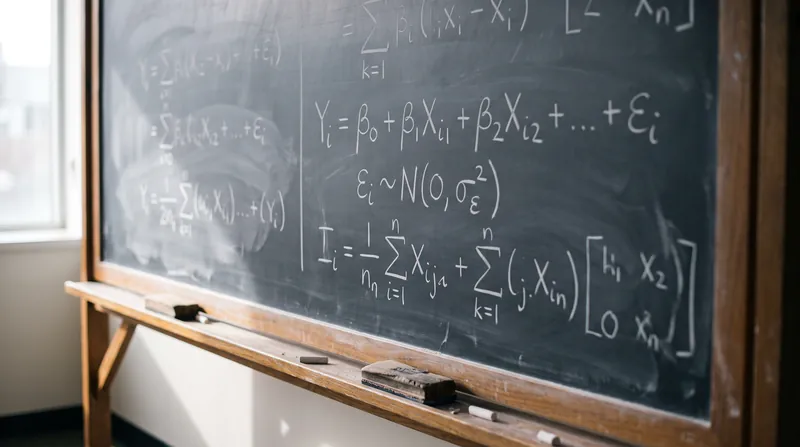
فرمول ریاضی که جهت و بزرگی سوگیری متغیر حذفشده در رگرسیون را تعیین میکند
6 منبع · 14 روز پیش
سه شرطی که سازوکار دادههای گمشده را تعریف میکنند (MCAR، MAR، MNAR)
5 منبع · 15 روز پیش
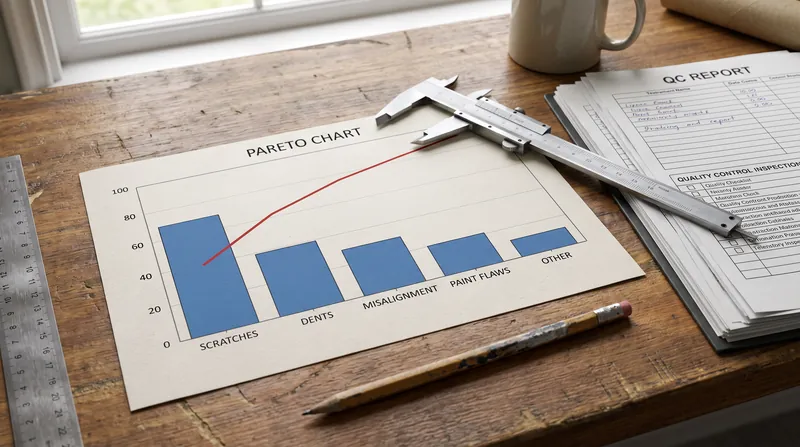
چگونه خط تجمعی در نمودار پارتو اصل ۸۰/۲۰ را در کنترل کیفیت کمیتسنجی میکند
5 منبع · 15 روز پیش
چرخه پیشبینی-بهروزرسانی فیلتر کالمن چگونه خطای تخمین وضعیت را در سریهای زمانی به حداقل میرساند
10 منبع · 15 روز پیش
چگونه الگوریتمهای بینابینی، نزدیکی و بردار ویژه، قدرت را در یک شبکه تعریف میکنند
6 منبع · 15 روز پیش
چگونه تصادفیسازی محلی در نزدیکی یک نقطه برش، اثرات علی را در دادههای مشاهدهای مجزا میکند
9 منبع · 15 روز پیش
چگونه الگوریتمهای کنترل ساختگی با ایجاد سناریوهای جایگزین، نتایج سیاستگذاریها را میسنجند
5 منبع · 15 روز پیش
چگونه یک متغیر میانجی مسیر علی را توضیح میدهد، در حالی که یک متغیر تعدیلگر شدت آن را تغییر میدهد
7 منبع · 15 روز پیش
چگونه اندازه اثر، آلفا و توان آماری برای تعیین حجم نمونه آزمایش در هم قفل میشوند
6 منبع · 16 روز پیش
چگونه نمودارهای دو محوره همبستگیهای کاذب میسازند و چرا نمودارهای نسبتی این اعوجاج را برطرف میکنند
6 منبع · 16 روز پیش
چگونه سه شرط ریاضی اعتبار یک متغیر ابزاری را تایید میکنند
7 منبع · 16 روز پیش
چگونه تنظیمات بونفرونی و نرخ کشف کاذب از مثبتهای کاذب در مجموعهدادههای عظیم جلوگیری میکنند
6 منبع · 16 روز پیش
چرا توافق درصد ساده در دادههای نامتوازن شکست میخورد و چگونه کاپای کوهن آن را اصلاح میکند
7 منبع · 16 روز پیش
چگونه قضیه حد مرکزی آشوب را مجبور به تبعیت از منحنی زنگولهای میکند
6 منبع · 16 روز پیش
چگونه نابرابری کرامر-رائو کف مطلق واریانس آماری را تعیین میکند
6 منبع · 16 روز پیش
چگونه بازنمونهگیری با جایگذاری، توزیع نمونهگیری هر آمارهای را تخمین میزند؟
8 منبع · 17 روز پیش
چگونه نمودارهای ویولن، چندوجهیهای پنهانی را که آمار خلاصه حذف میکند، آشکار میسازند
7 منبع · 17 روز پیش
کالبدشکافی آریما: چگونه خودرگرسیون، تفاضلگیری و میانگین متحرک برای پیشبینی سریهای زمانی ترکیب میشوند
7 منبع · 17 روز پیش
چگونه یک داده پرت جدول ردهبندی را زیر و رو میکند: شکاف ریاضی بین استانداردسازی نمره Z و نرمالسازی مین-مکس
5 منبع · 17 روز پیش
چرا معیار F1 (اف-وان) عدم توازن شدید بین دقت (Precision) و فراخوانی (Recall) را در یادگیری ماشین جریمه میکند؟
6 منبع · 17 روز پیش
بررسی شواهد: ساعتهای هوشمند تجاری تا چه حد معماری خواب را در مقایسه با پلیسومنوگرافی بالینی اندازهگیری میکنند؟
6 منبع · 17 روز پیش
چگونه تنظیمکنندگی L1 ضرایب را به صفر میرساند در حالی که رگرسیون ریج همه آنها را حفظ میکند
8 منبع · 17 روز پیش
چگونه مرزهای عددی دلخواه، علت و معلول را در دادههای مشاهدهای جدا میکنند
7 منبع · 17 روز پیش
چرا جایگزینی با میانگین، واریانس دادهها را مخدوش میکند و چگونه معادلات زنجیرهای آن را حفظ میکنند؟
7 منبع · 18 روز پیش
کاوش موضوعات بیشتر
نمایش 51 تا 100 از 251