
ردپای مادی هوش مصنوعی: برآورد هزینههای انرژی، آب و نیروی کار مدلهای زایشی
گذار از بازیابی دادههای دیجیتال به تولید فعال آنها، میزان برق مصرفی در هر تعامل را ۱۰ برابر افزایش داده و بار زیستمحیطی محاسبات جهانی را دگرگون کرده است. ارزیابی جامع دیوان محاسبات آمریکا نشان میدهد که این تغییر معماری چگونه شبکههای برق را تحت فشار قرار میدهد، منابع گسترده آب را میبلعد و فرسودگی سختافزارها را تسریع میکند.
به قلم فرشید جمشیدی
این خبر را به اشتراک بگذارید
اعداد کلیدی
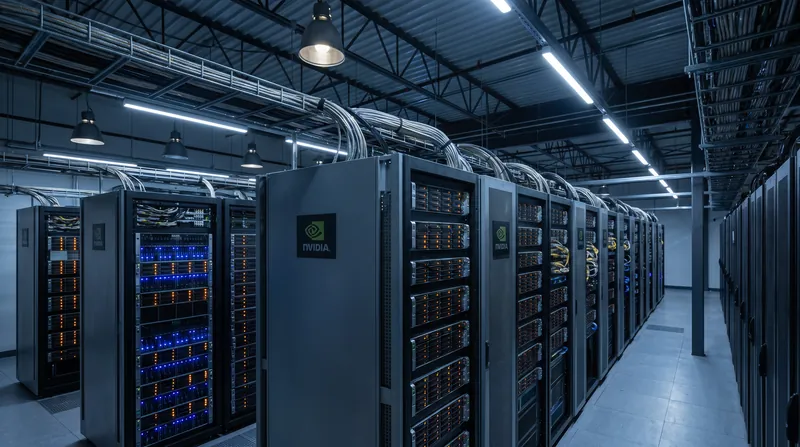
زیرساخت فیزیکی لازم برای پاسخگویی به یک پرسش دیجیتال بهشکلی بنیادین گسترش یافته و بار زیستمحیطی محاسبات را از ذخیرهسازی غیرفعال دادهها به تولید فعال محتوا کشانده است. این گذار ساختاری پیامدهای عمیقی برای شبکههای انرژی و منابع آب در سراسر جهان به همراه دارد.[1]
یک جستوجوی معمولی در وب برای بازیابی نتایج نمایهشده از پایگاههای داده موجود، به حدود ۰.۳ واتساعت برق نیاز دارد. این فرایندِ بهشدت بهینهسازیشده، بیش از بیست سال است که خط مبنای مصرف انرژی اینترنت مصرفی را تعیین کرده است.[1]
در مقابل، درخواست از یک مدل هوش مصنوعی زایشی برای بازتولید و سنتز پاسخی تازه، نزدیک به ۳ واتساعت برق مصرف میکند؛ یعنی تقاضای انرژی به ازای هر تعامل ده برابر میشود. با تعمیم این میزان به میلیاردها کاربر روزانه، این تغییر معماری به منابع فیزیکی بیسابقهای نیاز پیدا میکند.[1]
این هزینه عملیاتی چشمگیر در کانون گزارش جامع ارزیابی فناوری منتشرشده توسط دیوان محاسبات آمریکا (GAO) قرار گرفته است. این نهاد نظارتی پیامدهای زنجیرهای این فناوری را بر زیرساختهای فیزیکی، بازارهای کار و خدمات عمومی بررسی کرده است.[1]
گزارش آوریل ۲۰۲۵ که با شناسه GAO-25-107172 ثبت شده، اثرات محیطزیستی و انسانی سیستمهای زایشی را در جریان گسترش آنها در اقتصاد جهانی کمّیسازی میکند. یافتههای این گزارش نشاندهنده چشماندازی است که بر پایه مصرف کلان منابع و شکافهای حیاتی در شفافیت سازمانی شرکتها شکل گرفته است.[1]
مکانیک انرژی در مرحله استنتاج
ناهمخوانی فاحش در مصرف انرژی ریشه در تفاوت ریاضی محض میان «بازیابی» و «تولید» دارد. موتورهای جستوجوی سنتی کلمات کلیدی را با نمایههای ازپیشگردآوریشده تطبیق میدهند؛ روندی کاملاً بهینهشده که اجرای آن به کمترین توان محاسباتی فعال نیاز دارد.[1]
برعکس، مدلهای زایشی توزیع احتمالی تکتک واژههای متوالی را در طول اجرای پرسمان، روی میلیاردها پارامتر بهصورت بیدرنگ محاسبه میکنند. این ضرب پیوسته ماتریسها مستلزم فعالیت هزاران پردازنده تخصصی با حداکثر توان عملیاتی در تمام طول پردازش است.[1]
دیوان محاسبات آمریکا خاطرنشان میکند که این برنامهها در حال حاضر ۱۰ تا ۲۰ درصد از کل برق مراکز داده را مصرف میکنند. گروههای پژوهشی مالی نیز پیشبینی کردهاند که بارهای کاری هوش مصنوعی تا سال ۲۰۳۰ به ۲۰ درصد کامل از توان مصرفی مراکز داده خواهند رسید.[1]
اثر انباشته میلیاردها پرسش روزانه ممکن است زیرساختهای فعلی انتقال نیرو در قطبهای اصلی فناوری را به زانو درآورد. همگام با گسترش استقرار این سامانهها، برق مورد نیاز برای اجرای مدلها بهتدریج با توان لازم برای آموزش اولیه آنها برابری میکند.[1]
در گزارش فدرال آمده است: «با ادغام هوش مصنوعی زایشی در محصولات و خدمات صنایع مختلف، تفکیک مصرف انرژی و آب میان هوش مصنوعی زایشی، سایر شاخههای هوش مصنوعی و توانمندیهای غیرمرتبط با آن بسیار دشوار خواهد بود.»[1]
این کمبود دادههای تفکیکشده و دقیق، هزینه واقعی زیستمحیطی فناوری را از چشم سیاستگذاران و اپراتورهای شبکه پنهان میکند. بدون دسترسی به دورسنجی دقیق، تأمینکنندگان برق محلی در پیشبینی جهشهای ناگهانی بار شبکه ناشی از پردازشهای سنگین محاسباتی با چالش جدی مواجه میشوند.[1]
آژانس بینالمللی انرژی برآورد میکند که مصرف برق مراکز داده آمریکا در سال ۲۰۲۲ حدود ۴ درصد از کل تقاضای داخلی این کشور را به خود اختصاص داده بود. پیشبینی میشود این سهم تا پایان سال ۲۰۲۶ به ۶ درصد افزایش یابد.[1][4]
مدلهای محافظهکارانهترِ پژوهشگاه ملی لارنس برکلی نشان میدهند که تقاضای کل توان مراکز داده میتواند تا سال ۲۰۲۸ تا ۱۲ درصد از برق مصرفی ایالات متحده را به خود اختصاص دهد. این مسیر رشد مستقیماً تحت تأثیر شتاب پذیرش ابزارهای زایشی قرار دارد.[1][3]
هزینه اولیه سنگین در آموزش مدلها
پیش از آنکه مدلی بتواند حتی یک پاسخ تولید کند، باید مرحله آموزشی فشردهای را پشت سر بگذارد که مستلزم مقادیر هنگفت و متمرکزی از انرژی است. این سرمایهگذاری اولیه، آشکارترین بخش از ردپای کربنی فناوری به شمار میرود.[1]
آموزش شامل تغذیه مجموعهدادههای عظیم به یک فرایند بهینهسازی بهمنظور تنظیم وزنهای درونی مدل است؛ سازوکاری که ماهها زمان میبرد. انرژی مورد نیاز با ابعاد مدل و حجم دادههای آموزشی رابطه تصاعدی دارد.[1]
مدل ۱۷۶ میلیارد پارامتری بلوم (BLOOM) که در ژوئیه ۲۰۲۲ عرضه شد، در طول دوره آموزش خود ۴۳۳.۲ مگاواتساعت برق مصرف کرد. این فرایند حدود ۵۰.۵ تن متریک معادل دیاکسید کربن تولید کرد.[1]
مدل جیپیتی-۳ شرکت OpenAI با ۱۷۵ میلیارد پارامتر، در سال ۲۰۲۰ برای آموزش نیازمند حدود ۱,۲۸۷ مگاواتساعت برق بود. این معماری اولیه در مرحله نخستین بهینهسازی خود ۵۵۲.۱ تن متریک انتشار کربن بر جای گذاشت.[1]
تا ژوئیه ۲۰۲۴، مدل لاما ۳.۱ متا با ۴۰۵ میلیارد پارامتر به مصرف خیرهکننده ۲۱,۵۸۸ مگاواتساعت برق رسید. فرایند آموزش این مدل ۸,۹۳۰ تن متریک معادل دیاکسید کربن منتشر کرد که نشاندهنده هزینههای فزاینده مدلهای خط مقدم است.[1]
شدت انتشار کربن در این فرایند آموزشی بهطور کامل به موقعیت جغرافیایی مرکز داده و ترکیب شبکه برق محلی آن بستگی دارد. توسعهدهندگان میتوانند با استقرار هوشمندانه مراکز خود در نزدیکی منابع تجدیدپذیر، انتشار گازهای گلخانهای حوزه ۲ (Scope 2) را بهشدت کاهش دهند.[1]
یک مرکز در شمال غربی آمریکا که از نیروگاههای برقآبی بهره میبرد، انتشار بسیار کمتری در قیاس با مرکز مستقر در غرب میانه متکی به سوخت زغالسنگ دارد. این گوناگونی منطقهای، تلاشها برای استانداردسازی گزارشدهی زیستمحیطی در کل صنعت را پیچیده میکند.[1]
با وجود این ارقام شگفتانگیز، توسعهدهندگان تجاری بهندرت دادههای جامع مصرف انرژی را برای پیشرفتهترین سامانههای خود فاش میکنند. پژوهشگران مستقل ناچارند برای محاسبه بار زیستمحیطی به مشخصات فنی سختافزارها و برآورد زمان آموزش اتکا کنند.[1][2]
کربن تجسمیافته و چرخه حیات سختافزار
برق مصرفشده در طول مراحل آموزش و استنتاج، تنها گوشهای از ردپای اکولوژیک فراگیر این فناوری است. سختافزار مادی مورد نیاز برای انجام این محاسبات، حامل بار عظیمی از «کربن تجسمیافته» ناشی از تولید است.[1]
این انتشارات حوزه ۳ شامل استخراج مواد اولیه، فرایند تولید ویفرهای سیلیکونی و حملونقل سرورهای نهایی است. زنجیره ساخت نیمهرساناهای پیشرفته از منظر شدت مصرف انرژی یکی از سنگینترین صنایع جهان است.[1]
دیوان محاسبات آمریکا به تحقیقاتی استناد میکند که نشان میدهد تولید سختافزار، ۵۰ درصد دیگر به کل ردپای کربنی آموزش و بهرهبرداری از هوش مصنوعی میافزاید. این کربن تجسمیافته اغلب در گزارشهای پایداری عمومی شرکتها پنهان میماند.[1]
پردازندههای گرافیکی تخصصی که ستون فقرات این سامانهها را تشکیل میدهند، طول عمر عملیاتی نسبتاً کوتاهی دارند. تنشهای شدید حرارتی و الکتریکی ناشی از کارکرد مدام، مسیرهای میکروسکوپی سیلیکون را بهسرعت فرسوده میکند.[1]
کارشناسان صنعت تخمین میزنند که یک واحد پردازشی نوعی، تنها پس از چهار سال کارکرد مداوم به پایان پنجره عملکرد تضمینشده خود میرسد. این چرخه استهلاک شتابان، گردانندگان مراکز داده را وادار میکند تا زیرساختهای محاسباتی خود را دائماً نوسازی کنند.[1]
دفع و بازیافت این قطعات پیچیده الکترونیکی چالشهای زیستمحیطی سهمگینی دارد. استخراج فلزات کمیاب زمینی از سرورهای اسقاطشده از نظر اقتصادی و فنی همچنان دشوار است و به انباشت فزاینده پسماند الکترونیکی منجر میشود.[1][2]
افزون بر این، احداث خودِ ساختمانهای مراکز داده نیازمند مقادیر انبوهی از فولاد و بتن است. واکنشهای شیمیایی رخداده در فرایند تولید سیمان، حجم عظیمی از دیاکسید کربن را مستقیماً وارد جو میکند.[1]
گزارشهای زیستمحیطی اخیر غولهای فناوری حاکی از افزایشهای دورقمی در میزان انتشار گازهای گلخانهای آنهاست که عمدتاً ناشی از سرمایهگذاری در زیرساختهای نوساز است. کربنزدایی از زنجیره تأمین فیزیکی به مانع بزرگی در برابر ادعاهای زیستمحیطی تبدیل شده است.[1]
ردپای پنهان مصرف آب
گرمای شدیدی که از عملکرد همزمان هزاران پردازنده ساطع میشود، برای جلوگیری از خرابی سختافزار نیازمند سامانههای خنککننده قدرتمند است. این راهکارهای مدیریت حرارتی نمایانگر هدررفت عظیم و کمتر دیدهشده منابع محلی هستند.[1]
مراکز داده بهطور سنتی بر برجهای خنککننده تبخیری تکیه دارند که برای حفظ دمای بهینه، مقادیر معتنابهی آب شیرین تبخیر میکنند. تا ۴۰ درصد از کل انرژی مصرفی یک مجتمع میتواند صرف پمپاژ آب و سرد کردن هوا شود.[1]
شاخص «اثربخشی مصرف آب» (WUE) نسبت مصرف سالانه آب یک تأسیسات را به برق مصرفی تجهیزات پردازشی آن میسنجد. نسبت کمتر در این فرمول به معنای سامانه خنککننده بهینهتر است.[1]
فرایند آموزش یک مدل زایشی طراز اول میتواند تا ۷۰۰,۰۰۰ لیتر آب شیرین را مستقیماً تبخیر کند. این حجم تقریباً معادل ۲۵ درصد حجم یک استخر المپیک است که صرفاً در یک دوره اجرای محاسباتی ناپدید میشود.[1]
مرحله عملیاتی و پاسخ به پرسشها نیز بهویژه در مناطق کمآب و خشکی که معمولاً مراکز داده در آنها احداث میشوند، سهم پیوستهای از منابع محلی طلب میکند. هر پرسمان پردازششده مستقیماً به هدررفت تبخیری آب میانجامد.[1]
برآوردهای دانشگاهی نشان میدهد یک سامانه زایشی به ازای هر ۱۰ تا ۵۰ پرسمان ارسالی از سوی کاربران، حدود ۰.۵ لیتر آب مصرف میکند. این مقدار بسته به اقلیم محلی و بازدهی مرکز داده بهشدت متغیر است.[1]
توسعهدهندگان تجاری بهندرت آمار مصرف آب خود را به تفکیک بارهای پردازشی افشا میکنند و این ابهام، بهای بومشناختی دقیق مدلها را نامشخص نگه میدارد. این پنهانکاری برنامهریزی شهری جوامع میزبان را با اختلال جدی روبرو ساخته است.[1][2]
برای غلبه بر این تشنگی مفرط، مهندسان به راهکارهای خنککاری مایع روی آوردهاند؛ از جمله روشهای غوطهوری که در آنها سختافزار مستقیماً در سیالات دیالکتریک ویژه غرق میشود. این چرخههای بسته نیاز مداوم به برداشت آب شیرین را به صفر نزدیک میکنند.[1]
تقویت توان انسان و دگرگونیهای بازار کار
فراتر از ابعاد مادی، استقرار سامانههای زایشی تغییرات عمیقی در بازارهای کار و بهرهوری نیروی انسانی پدید آورده است. این تحول ساختاری، سازوکار بنیادین کارهای دانشی را در بخشهای متعددی دگرگون میسازد.[1]
این فناوری عمدتاً در نقش یک ابزار تقویتی عمل میکند و به جای خودکارسازی کامل نقشهای حرفهای پیچیده، توانمندیهای انسانی را ارتقا میدهد. بیشترین برتری آن در خلاصهسازی متون انبوه و تنظیم پیشنویس مکاتبات روتین است.[1]
پژوهش سال ۲۰۲۳ در یکی از شرکتهای نرمافزاری فورچون ۵۰۰ نشان داد که کارشناسان خدمات مشتریان با بهرهگیری از دستیار هوش مصنوعی توانستهاند شمار بیشتری از مسائل را در هر ساعت حلوفصل کنند. دستیار با رصد پیامها، پاسخهای پیشنهادی بیدرنگ ارائه میداد.[1]
رشد بهرهوری در میان پرسنل نامتوازن بود؛ نیروهای تازهوارد و کممهارت بیشترین پیشرفت عملکردی را تجربه کردند، در حالی که کارکنان باتجربه و زبده تغییر چشمگیری در نرخ رسیدگی خود ندیدند.[1]
این پویایی نشان میدهد که ابزارهای زایشی میتوانند کف عملکرد شغلی را بهسرعت بالا بکشند و روند سنتی کسب مهارت را متحول سازند؛ بهطوریکه نیروهای مبتدی در سطحی نزدیک به کهنهکاران فعالیت کنند.[1][2]
با این حال، خودکارسازی وظایف اداری و تولید محتوای روتین، نگرانیها از ناامنی شغلی و حذف فرصتهای استخدامی سطح پایه را تشدید کرده است. این تغییر میتواند مسیر ورود نسلهای آینده به بازار کار را با موانع سخت روبرو کند.[1]
ادغام این سامانهها در محیطهای کاری مخاطره پدید آمدن سازوکارهای نظارتی و پایش مداوم کارمندان را نیز به همراه دارد. جمعآوری پیوسته دادههای کارمندان در صورت مدیریت نامناسب میتواند حریم خصوصی و شأن حرفهای را تضعیف کند.[1]
سازمانها باید اشتیاق به افزایش کارایی را با لزوم بازآموزی جامع پرسنل و حفظ تخصص موضوعی افراد متعادل کنند. وابستگی بیشازحد به سامانههای خودکار ممکن است به مرور زمان توانایی تفکر نقادانه کارکنان را تحلیل ببرد.[1]
مخاطرات سیستمیک و مسئله جعبه سیاه
پذیرش شتابان ابزارهای زایشی در نهادهای دولتی و ساختارهای آموزشی، مخاطرات ذاتی آنها را دوچندان میکند. بهکارگیری این سیستمها در بسترهای پرریسک و حساس نیازمند ارزیابیهای سختگیرانه و پایش پیوسته است.[1]
این مدلها بهمثابه «جعبههای سیاه» رفتار میکنند؛ یعنی حتی سازندگانشان نیز قادر نیستند سازوکار دقیق تولید یک خروجی معین را از دل لایههای پنهان شبکههای عصبی تبیین کنند. فقدان تفسیرپذیری، پاسخگویی حقوقی را عملاً ناممکن میسازد.[1]
هنگامی که این سامانهها اطلاعات غلط، توهمات زبانی یا گزارههای سوگیرانه تحویل میدهند، راهکارهای حقوقی و ترمیمی کاربران بهشدت محدود است. ناشناخته بودن جزئیات دادههای آموزشی، ردیابی منشأ خطاها را غیرممکن میکند.[1]
در یک نمونه ثبتشده، بات شهرداری به شهروندان پاسخ داده بود که مجتمعهای مسکونی شهر ملزم به پذیرش بنهای مسکن دولتی (ماده ۸) نیستند؛ در حالی که تارنمای رسمی شهرداری صراحتاً خلاف این ادعا را اعلام میکرد.[1]
این مدلها در برابر تهدیدات پیشرفته سایبری نیز آسیبپذیرند؛ از جمله حملات «تزریق دستور» (Prompt Injection) که سازوکارهای ایمنی را دور میزنند. مهاجمان میتوانند سیستم را برای استخراج دادههای حساس یا تولید کدهای مخرب دستکاری کنند.[1]
مجموعهدادههای گردآوریشده از پهنه اینترنت عمومی غالباً حاوی اطلاعات هویتی افراد است و این امر تهدید پایدار حریم خصوصی کاربران را رقم میزند. حفاظت از این دادهها نیازمند معماریهای ارتقادهنده امنیت دادههاست تا کنترل بر هویت دیجیتال به افراد بازگردد.[1]
سوگیریهای ناخواستهای که در بافت دادههای آموزشی ریشه دواندهاند، میتوانند به تبعیض علیه اقلیتها و سخنوران زبانهای غیرانگلیسی منجر شوند. سامانههایی که اساساً بر دادههای وب غربی آموزش دیدهاند، بافتارهای گوناگون بومی را منعکس نمیکنند.[1]
توسعهدهندگان تجاری میکوشند از طریق فرایندهای سختگیرانه ارزیابی تخاصمی (Red Teaming)، پالایش مجموعهدادهها و تدوین دستورالعملهای ایمنی از این خطرات بکاهند؛ هرچند راستیآزمایی بیطرفانه کارآمدی این روشها هنوز دشوار است.[1][2]
بهرهوری و پدیده تناقض جونز
سیاستگذاران و رهبران حوزه فناوری در مسیر توسعه پایدار با یک مسئله بهینهسازی پیچیده روبهرو هستند. متوازن ساختن منافع خیرهکننده با بار سنگین مصرف منابع نیازمند اقدامات هماهنگ قانونی است.[1]
نوآوریهای الگوریتمی نظیر هرس کردن پارامترهای کماثر و کمّیسازی دقت عددی مقادیر (Quantization)، پیچیدگی محاسباتی را بهشدت کاهش میدهند. این تدابیر مصرف انرژی را در هر دو مرحله آموزش و استنتاج پایین میآورند.[1]
سازندگان سختافزار پیوسته پردازندههای پربازدهتری به بازار عرضه میکنند، بهگونهای که برخی مدعی کاهش ۲۵ برابری مصرف برق نسبت به نسلهای گذشته شدهاند. این تحولات برای مهار رشد نمایی مصرف الکتریسیته بسیار حیاتی به نظر میرسند.[1]
با این حال، جهش در کارایی معمولاً پدیده شناختهشده «تناقض جونز» را شعلهور میکند؛ جایی که افت هزینههای عملیاتی سبب فوران تقاضا میشود. ارزانتر شدن پردازش هر پرسمان، دامنه کاربری را چنان میگستراند که کل انرژی مصرفی افزایش مییابد.[1][2]
برای تضمین تأمین پایدار برق پاک و بدون کربن برای این زیرساختها، شرکتهای بزرگ بهشکل فزایندهای به انرژی هستهای چشم دوختهاند. این رویکرد بیانگر بازآرایی بنیادین استراتژی انرژی در اقتصاد دیجیتال است.[1]
در اواخر سال ۲۰۲۴، چند شرکت مطرح قراردادهایی را برای خرید برق از نیروگاههای هستهای بازراهاندازیشده و راکتورهای مدولار کوچک (SMR) امضا کردند. این منابع انرژی پیوسته بدون کربن برای تقاضای همیشگی مراکز داده بسیار ایدئال هستند.[1]
دیوان محاسبات آمریکا گزینههای سیاستی مختلفی را برای مواجهه با این شرایط پیشنهاد میکند؛ از جمله ارتقای شیوه گردآوری دادهها و الزام به استفاده از چارچوبهای استاندارد مدیریت ریسک. تداوم وضع کنونی خطرات زیستمحیطی و اجتماعی را دوچندان میکند.[1]
آنچه نمیدانیم
- سهم دقیق هوش مصنوعی زایشی از کل برق مصرفی فعلی مراکز داده در مقایسه با سایر پردازشها.
- میزان دقیق آب مصرفی مدلهای تجاری در مرحله عملیاتی پاسخگویی به کاربران (استنتاج).
- ابعاد کامل خسارات زیستمحیطی ناشی از اسقاط سختافزارهای فرسوده و انباشت زبالههای الکترونیکی.
نکات کلیدی
- پرسمانهای هوش مصنوعی زایشی تقریباً ۱۰ برابر بیشتر از یک جستوجوی معمولی مبتنی بر کلمات کلیدی برق مصرف میکنند.
- فرایند ساخت سختافزار و احداث زیرساختها، بار ردپای کربنی کل این فناوری را تا حدود ۵۰ درصد افزایش میدهد.
- عمر کوتاه پردازندههای گرافیکی تخصصی (حدود ۴ سال) هزینههای زیستمحیطی ناشی از نوسازی مداوم مراکز داده را دوچندان کرده است.
- اگرچه ابزارهای زایشی بهرهوری نیروهای انسانی را بهبود میبخشند، عملکرد «جعبه سیاه» آنها پاسخگویی را مخدوش و خطرات گستردهای برای حریم خصوصی ایجاد میکند.
- پژوهشگران محیطزیست
- بر ابعاد فزاینده مصرف انرژی، آب و ردپای کربنی مراکز داده تمرکز دارند و خواستار گزارشدهی شفاف و زیرساختهای پایدار هستند.
- توسعهدهندگان صنعت
- اولویت خود را بر ارتقای بهرهوری الگوریتمی، نوآوری سختافزاری و تأمین انرژی هستهای بدون کربن برای پاسخ به تقاضای تصاعدی پردازش متمرکز کردهاند.
- تحلیلگران سیاستگذاری
- بر لزوم پیادهسازی چارچوبهای استاندارد ارزیابی ریسک، آزمونهای ایمنی مستقل و نظارت قانونی برای کاهش خطرات سیستمیک جعبهسیاه اصرار دارند.
- اقتصاددانان کار
- تحولات بازار کار را بررسی میکنند و بر این باورند که مدلهای زایشی گرچه کارکنان مبتدی را تقویت میکنند، ممکن است به حذف مشاغل سطح ورود منجر شوند.
دیدگاههایی که این گزارش پوشش نداده
- جوامع بومی و محلی میزبان مراکز داده عظیم
- گردانندگان شبکههای توزیع برق در مواجهه با جهشهای موضعی بار
منابع
پوشش منابع
4 منبع
4 دیدگاه شناساییشده


- [1]U.S. Government Accountability Officeتحلیلگران سیاستگذاری
Artificial Intelligence: Generative AI's Environmental and Human Effects (GAO-25-107172)
مطالعه در U.S. Government Accountability Office → - [2]تیم سردبیری کوهستانتحلیلگران سیاستگذاری
تحلیل تیم سردبیری کوهستان
مطالعه در تیم سردبیری کوهستان → - [3]Lawrence Berkeley National Laboratoryپژوهشگران محیطزیست
2024 United States Data Center Energy Usage Report
مطالعه در Lawrence Berkeley National Laboratory → - [4]International Energy Agencyپژوهشگران محیطزیست
Electricity 2024: Analysis and forecast to 2026
مطالعه در International Energy Agency →
بیشتر در هوش مصنوعی
مشاهده همه →همراستایی هوش مصنوعی
سه مؤلفه مسئله کنترل هوش مصنوعی: تعیین مشخصات، تابآوری و تضمین
7 منبع
معماری مدل
چگونه مقداردهی اولیه خاویر از محو شدن و انفجار گرادیانها در شبکههای عصبی عمیق جلوگیری میکند
6 منبع
اقتصاد استنتاج
هزینه درجه دوم در برابر سود خطی: چگونه اندازه مدل باعث افزایش تاخیر و هزینه استنتاج میشود
9 منبع
همسویی مدل
چگونه ترجیحات انسانی مدل پاداش را برای همسویی رفتار هوش مصنوعی آموزش میدهند
7 منبع
نظرات
هر زاویه. هر روز.
اخبار هوش مصنوعی با پوشش کامل منابع و تحلیل دیدگاهها، هر روز و رایگان.