
چگونه معماری «آرتیایکس اسپارک» انویدیا پردازش هوش مصنوعی را به رایانههای شخصی محلی منتقل میکند
این سیستم-روی-تراشه جدید، یک پردازنده گرافیکی بلکول (Blackwell GPU) و یک پردازنده مرکزی گریس (Grace CPU) را با حافظه یکپارچه ترکیب میکند و به دستگاههای ویندوزی اجازه میدهد تا عوامل هوش مصنوعی بزرگ را بدون وابستگی به فضای ابری، به صورت محلی اجرا کنند.
به قلم آرش رضایی
این خبر را به اشتراک بگذارید
بهطور خلاصه
- ابرتراشه «آرتیایکس اسپارک» انویدیا، یک پردازنده مرکزی گریس و یک پردازنده گرافیکی بلکول را با حداکثر ۱۲۸ گیگابایت حافظه یکپارچه ترکیب میکند.
- این معماری ۱ پتافلاپ عملکرد هوش مصنوعی FP۴ ارائه میدهد و مدلهای ۱۲۰ میلیارد پارامتری را قادر میسازد به صورت محلی اجرا شوند.
- «انویدیا اوپنشل» و اصول امنیتی جدید ویندوز، عوامل هوش مصنوعی محلی را برای محافظت از حریم خصوصی کاربر، سندباکس میکنند.
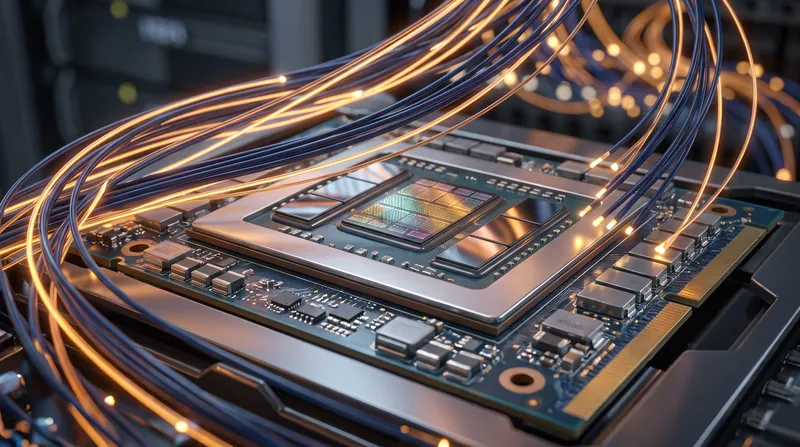
با عملکرد هوش مصنوعی ۱ پتافلاپ (Petaflop) در دقت FP۴، سقف پردازشی برای یک رایانه شخصی اساساً تغییر کرده است. ابرتراشه «آرتیایکس اسپارک» انویدیا، یک سیستم-روی-تراشه مبتنی بر معماری آرم (Arm) است که با همکاری عمیق مایکروسافت و مدیاتک طراحی شده و یک پردازنده مرکزی ۲۰ هستهای گریس (Grace CPU) و یک پردازنده گرافیکی بلکول آرتیایکس (Blackwell RTX GPU) را در یک بسته واحد و یکپارچه ادغام میکند.
با اتصال این اجزای پردازشی از طریق رابط پرسرعت NVLink-C2C و تجمیع تا ۱۲۸ گیگابایت حافظه یکپارچه، این معماری گلوگاههای سختافزاری سنتی را که قبلاً کارهای سنگین هوش مصنوعی را به مراکز داده دوردست تحمیل میکرد، حذف میکند. این طراحی سیلیکونی به طور خاص دسته نوظهور عوامل هوش مصنوعی محلی را هدف قرار میدهد و بار سنگین را مستقیماً از فضای ابری به میز کاربر منتقل میکند.[1][2]
تمرکز اصلی مهندسی معماری «آرتیایکس اسپارک» بر تسهیل «عامل شخصی» (personal agent) است—یک دستیار هوش مصنوعی مستقل و همیشه روشن که میتواند در چندین برنامه استدلال کند و وظایف پیچیده را بدون ارسال دادههای کاربر به سرورهای خارجی اجرا کند. اجرای یک مدل عظیم ۱۲۰ میلیارد پارامتری به صورت محلی نیازمند پهنای باند و ظرفیت حافظه فوقالعادهای است که معماریهای استاندارد لپتاپ x۸۶ معمولاً در یک پاکت توان قابل حمل، برای تأمین آن با مشکل مواجه هستند.
با استفاده از حداکثر ۱۲۸ گیگابایت حافظه یکپارچه LPDDR۵X، پردازنده مرکزی گریس و پردازنده گرافیکی بلکول میتوانند به طور همزمان به یک مجموعه داده مشترک دسترسی داشته باشند. این معماری مشترک، تأخیر و هزینه توان ناشی از کپی کردن دادهها بین مادربرد را از بین میبرد و امکان پاسخگویی بلادرنگ برای کارهای مولد پیچیده را فراهم میکند.[1][3]
یک تمایز فنی حیاتی در معیار عملکرد اصلی این سختافزار، دقت خاص محاسبات درگیر است. قابلیت محاسباتی اعلام شده ۱ پتافلاپ به طور خاص در FP۴ یا عملیات ممیز شناور ۴ بیتی اندازهگیری میشود. از آنجایی که محاسبات FP۴ دقیقاً یک چهارم دادههای مورد نیاز برای عملیات استاندارد ۱۶ بیتی را جابجا میکنند، هستههای تنسور نسل پنجم این تراشه میتوانند تعداد بسیار بیشتری عملیات در ثانیه اجرا کنند.
این محاسبات با دقت پایینتر، برای اجرای مدلهای هوش مصنوعی از پیش آموزش دیده—که به عنوان استنتاج (Inference) شناخته میشود—به شدت بهینهسازی شدهاند، نه برای آموزش آن مدلها از ابتدا. با معاوضه دقت غیرضروری با سرعت خام، این معماری به یک دسکتاپ جمعوجور یا یک لپتاپ با ضخامت ۱۴ میلیمتر اجازه میدهد تا بارهای کاری مولد عظیمی را که معمولاً به یک رک سرور اختصاصی نیاز دارند، مدیریت کند.[2][3]
برای اینکه عوامل مستقل محلی از نظر عملی قابل اجرا باشند، سختافزار زیربنایی باید با یک سیستم عامل که قادر به سندباکس (Sandboxing) سختگیرانه نرمافزار است، جفت شود. مایکروسافت و انویدیا مجموعهای از اصول امنیتی جدید را به طور مشترک و به طور خاص برای ویندوز مبتنی بر آرم، در کنار یک محیط زمان اجرای اختصاصی به نام «انویدیا اوپنشل» (Nvidia OpenShell) توسعه دادند.
این چارچوب یکپارچه، محدودیت هویت و اجرای سیاست سختگیرانه را در سطح سختافزار فراهم میکند. این امر تضمین میکند که یک عامل هوش مصنوعی که صفحه نمایش کاربر را میخواند، ایمیلهای خصوصی را تجزیه و تحلیل میکند یا به فایلهای مالی محلی دسترسی دارد، نمیتواند خودسرانه آن دادههای شخصی حساس را به سمت یک سرور شخص ثالث خارجی ارسال کند، و یکی از تردیدهای اصلی شرکتها در مورد پذیرش هوش مصنوعی را حل میکند.[1][3]
تغییر به سمت پردازش محلی، اساساً محاسبات مربوط به حریم خصوصی و تأخیر را برای امنیت سازمانی و جریانهای کاری خلاقانه سنگین تغییر میدهد. هنگامی که یک عامل هوشمند به طور کامل روی دستگاه کار میکند، میتواند فوراً اسناد محلی امن را تجزیه و تحلیل کند، جریانهای ویدیویی ۱۲K را در زمان واقعی ویرایش کند، یا محیطهای سهبعدی عظیم ۹۰ گیگابایتی را بدون تأخیر ذاتی رفت و برگشت ابری رندر کند.
تغییر به سمت پردازش محلی، اساساً محاسبات مربوط به حریم خصوصی و تأخیر را برای امنیت سازمانی و جریانهای کاری خلاقانه سنگین تغییر میدهد.
فروشندگان اصلی نرمافزار در حال حاضر در حال تطبیق با این تغییر معماری هستند؛ به عنوان مثال، ادوبی (Adobe) بازسازی برنامههای اصلی مانند پریمیر پرو (Premiere Pro) و فتوشاپ (Photoshop) را برای استفاده بومی از مجموعه حافظه یکپارچه و شتاب FP۴ «آرتیایکس اسپارک» آغاز کرده است، که نویدبخش زمانهای رندر بسیار سریعتر برای سازندگان محلی است.[1][2]
با وجود مشخصات سیلیکونی بسیار چشمگیر، عملکرد واقعی اکوسیستم «آرتیایکس اسپارک» به شدت به بلوغ لایههای ترجمه نرمافزاری وابسته است. از آنجایی که این ابرتراشه از مجموعه دستورالعمل آرم به جای معماری سنتی x۸۶ استفاده میکند، برنامههای ویندوزی قدیمی باید برای عملکرد از طریق شبیهساز «پریسم» (Prism) مایکروسافت اجرا شوند.
در حالی که برنامههای بومی آرم قادر خواهند بود به حداکثر بهرهوری توان و سرعت پردازش سختافزار دسترسی پیدا کنند، سربار محاسباتی شبیهسازی برای نرمافزارهای قدیمی و بهینهسازی نشده یک متغیر مهم است. آزمایشهای بنچمارک مستقل باید پس از رسیدن اولین موج دستگاههای مصرفکننده به بازار آزاد، این جریمه عملکردی را با دقت کمیسازی کنند.[2][3]
پیامد گستردهتر و بلندمدت معماری «آرتیایکس اسپارک»، جداسازی قطعی قابلیتهای پیشرفته هوش مصنوعی از خدمات ابری مبتنی بر اشتراک است. اگر یک کاربر استاندارد بتواند یک مدل استدلالی در سطح مرزی را مستقیماً روی لپتاپ اصلی خود اجرا کند، هزینههای محاسباتی جاری بلافاصله به قیمت پایه برق محلی کاهش مییابد.
این تمرکززدایی قدرت محاسباتی، صنعت فناوری گستردهتر را به سمت یک مدل سنتی مالکیت سختافزار محلی سوق میدهد. در این الگو، دستگاهی که روی میز قرار دارد به عنوان یک هوش مستقل عمل میکند، نه اینکه صرفاً به عنوان یک کلاینت نازک که به یک مزرعه سرور دوردست و درآمدزا متصل است، کار کند.[1][3]
در حالی که تولیدکنندگان بزرگ سختافزار از جمله ایسوس (Asus)، دل (Dell)، اچپی (HP) و لنوو (Lenovo) در حال آمادهسازی برای عرضه اولین موج دستگاههای «آرتیایکس اسپارک» هستند، این سیلیکون یک پایه جدید و قدرتمند برای اکوسیستم سختافزاری ویندوز ایجاد میکند.
انتقال اساسی از راهاندازی دستی برنامههای مجزا به تعامل با یک همکار هوش مصنوعی دائمی و در سطح سیستم، هم نیازمند سیلیکون خام برای اجرای مدلها و هم معماری امنیتی سختگیرانه برای مهار ایمن آنها است. با معرفی ابرتراشه «آرتیایکس اسپارک» و محیط زمان اجرای اوپنشل، زیرساخت فیزیکی و نرمافزاری لازم برای این انتقال اکنون به طور محکم برای بازار مصرفکننده فراهم شده است.[1][2]
بررسی عمیق دیدگاهها
دیدگاه مهندسی سختافزار
بر پیشرفتهای معماری حافظه یکپارچه و دقت FP۴ تمرکز دارد.
برای طراحان سیلیکون، «آرتیایکس اسپارک» نشاندهنده پیروزی در بستهبندی و پهنای باند حافظه است. با استفاده از NVLink-C2C برای پل زدن بین پردازنده مرکزی گریس و پردازنده گرافیکی بلکول، مهندسان گلوگاههای سنتی PCIe را که طراحیهای دسکتاپ استاندارد را آزار میدهند، دور زدهاند. اتکا به محاسبات ممیز شناور ۴ بیتی (FP۴) به ویژه قابل توجه است؛ این امر تصدیق میکند که استنتاج هوش مصنوعی نیازی به دقت بالای رندرینگ سنتی ندارد، و به تراشه اجازه میدهد تا تعداد عملیات عظیمی را در یک پاکت حرارتی سختگیرانه به دست آورد.
دیدگاه حریم خصوصی و امنیت
بر اهمیت پردازش محلی برای حاکمیت دادهها تأکید میکند.
مدافعان حریم خصوصی، تغییر به سمت عوامل هوش مصنوعی محلی را به عنوان یک اصلاح ضروری برای دوران «اول ابری» میبینند. هنگامی که یک مدل هوش مصنوعی ایمیلهای شخصی، اسناد مالی یا کدهای اختصاصی سازمانی را پردازش میکند، ارسال آن دادهها به یک سرور راه دور خطرات قابل توجهی از نظر رهگیری و انطباق ایجاد میکند. ترکیب پردازش روی دستگاه و محیط زمان اجرای اوپنشل تضمین میکند که استدلال عامل به صورت فیزیکی در سختافزار کاربر محصور باقی میماند و اساساً مشخصات امنیتی پذیرش هوش مصنوعی را تغییر میدهد.
دیدگاه اکوسیستم نرمافزار
چالشهای انتقال ویندوز به مجموعه دستورالعمل مبتنی بر آرم را برجسته میکند.
در حالی که سختافزار بسیار توانمند است، توسعهدهندگان نرمافزار به اصطکاک ناشی از انتقالهای معماری اشاره میکنند. از آنجایی که «آرتیایکس اسپارک» یک تراشه مبتنی بر آرم است، کتابخانه گسترده برنامههای ویندوزی قدیمی x۸۶ باید به شبیهساز «پریسم» مایکروسافت متکی باشد. توسعهدهندگان تأکید میکنند که تا زمانی که برنامههای اصلی به صورت بومی برای آرم بازنویسی نشوند، کاربران ممکن است در نرمافزارهای سنتی با جریمه عملکردی مواجه شوند، حتی در حالی که بارهای کاری خاص هوش مصنوعی با سرعتهای بیسابقهای اجرا میشوند.
- مهندسان سختافزار
- بر پیشرفتهای معماری حافظه یکپارچه و کارایی FP۴ که استنتاج محلی را ممکن میسازد، تمرکز دارد.
- مدافعان حریم خصوصی
- برای اصول امنیتی اوپنشل که دادههای حساس را به جای فضای ابری، روی دستگاه نگه میدارد، ارزش قائل است.
- توسعهدهندگان نرمافزار
- نگران انتقال به معماری آرم و سربار عملکردی شبیهسازی x۸۶ است.
دیدگاههایی که این گزارش پوشش نداده
- ارائهدهندگان خدمات ابری که با کاهش تقاضای استنتاج مواجه هستند
- تولیدکنندگان پردازندههای x۸۶ که برای اکوسیستم ویندوز رقابت میکنند
منابع
پوشش منابع
3 منبع
3 دیدگاه شناساییشده


- [1]Nvidia Newsroomمهندسان سختافزار
NVIDIA and Microsoft Reinvent Windows PCs for the Era of Personal AI Agents
مطالعه در Nvidia Newsroom → - [2]Wikipediaتوسعهدهندگان نرمافزار
Nvidia RTX Spark
مطالعه در Wikipedia → - [3]تیم سردبیری کوهستانمدافعان حریم خصوصی
تحلیل تیم سردبیری کوهستان
مطالعه در تیم سردبیری کوهستان →
بیشتر در هوش مصنوعی
مشاهده همه →زیرساخت هوش مصنوعی
چگونه کش KV مشکل تاخیر در مدلهای زبانی بزرگ را حل میکند
7 منبع
بنچمارکهای هوش مصنوعی
ارزیابان مستقل از اختلاف ۳۷ امتیازی در بنچمارک هوش مصنوعی GPT-6 Astra پرده برداشتند
6 منبع
هوش مصنوعی ژنومیک
دیپمایند اطلس آلفاژنوم را برای پیشبینی اثرات ۹ میلیارد جهش دیانای رونمایی کرد
3 منبع
زیرساخت محاسباتی
چگونه «پیجاتنشن» حافظه جیپییو را برای حل گلوگاه زمینه (Context) در مدلهای زبان بزرگ تقسیمبندی میکند؟
3 منبع
نظرات
هر زاویه. هر روز.
اخبار هوش مصنوعی با پوشش کامل منابع و تحلیل دیدگاهها، هر روز و رایگان.